Igranje šaha pomoću učenja potkrepljivanjem
Autori:
Veljko Galović, učenik II razreda Gimnazije „Veljko Petrović” u Somboru
Pavle Ivanović, učenik IV razreda Matematičke gimnazije u Beogradu
Mentori:
Nataša Jovanović, EPFL u Lozani
Milica Gojak, Elektrotehnički fakultet u Beogradu
Mateja Stojković, Elektrotehnički fakultet u Beogradu
Apstrakt
Ovaj projekat je razvio i evaluirao nekoliko pristupa zasnovanih na neuronskim mrežama za šahovski VI (veštačka inteligencija), eksperimentišući sa učenjem imitacije od Stockfish-a, ResNet mrežama za odabir poteza i vrednovanje pozicije, posebnom evaluacionom mrežom uparenom sa minimax pretragom, MCTS (Monte Karlo pretraga stabla) metodom sa samostalnim igranjem, i na kraju sa evaluatorom u NNUE stilu. Prikupljene su obimne količine podataka za treniranje (Lichess baza i partije samo-igre), implementirani su procesi obrade podataka za FEN pozicije sa Stockfish evaluacijama i najboljim potezima, a modeli su iterativno trenirani uz merenje validacione tačnosti, srednje kvadratne greške evaluacione glave i praktične snage igre. Ključni rezultati: (1) prvi dvoglavi i ResNet modeli pokazali su ograničeno poboljšanje u odnosu na nasumičnu igru; (2) model zasnovan isključivo na evaluaciji u kombinaciji sa minimax-om dao je najperspektivnije ponašanje u igri, ali je bio spor; (3) NNUE treniranje je u ranim epohama pokazalo nestabilne metrike i zahteva dodatno podešavanje i računske resurse.
Abstract
This project developed and evaluated several neural-network-based approaches for a Chess AI, experimenting with imitation learning from Stockfish, ResNet-based policy/value networks, a separate evaluation network paired with minimax search, Monte Carlo Tree Search (MCTS) with self-play, and finally an NNUE-style evaluator. Large-scale training data (Lichess database and self-play) was collected, data pipelines for FEN-encoded positions with Stockfish evaluations and best moves were implemented, and models were iteratively trained while measuring validation accuracy, evaluation-head mean-square error and practical playing strength. Key outcomes: (1) early two-headed and ResNet models showed limited improvement over random play; (2) an evaluation-only model combined with minimax produced the most promising playing behavior but was slow; (3) NNUE training produced unstable metrics in early epochs and requires further tuning and compute.
1. Uvod
Šah je jedna od najpoznatijih društevnih igara, pogotovo za ljude koji žele da testiraju svoje sposobnosti apstraktnog razmišljanja. Od nastanka računarstva kao naučne discipline, šah je služio kao velika inspiracija za razvoj veštačke inteligencije. To je kulminiralo u 1997. godini, kada je po prvi put računar pobedio tadašnjeg svetskog prvaka u šahu1. Od tog trenutka, najbolji igrači šaha su upravo kompjuteri, i zadatak je postao razviti najboljeg šahovskog kompjutera. Sve do 2017. godine dominirali su kompjuteri zasnovani na efikasnom kalkulisanju što je moguće više poteza unapred kada je svet kompjuterskog šaha doživeo preporod pojavom AlphaZero-a2. Nakon samo 9 sati treniranja, pobedio je tadašnji najbolji šahovski kompjutera Stockfish 83 ubedljivim rezultatom od 28 pobeda, 72 remija i 0 poraza, koristeći potpuno novi pristup. Takav događaj služi kao dokaz da i dalje postoji mnogo toga što ne znamo o šahu kao igri, i kao inspiracija za dalji rad i razvoj.
Cilj projekta jeste razvitak šahovskog kompjutera, po ugledu na najbolje komjutere sadašnjice. U okviru ovog rada isprobano je više pristupa: imitaciono učenje nad Stockfish-ovim potezima, ResNet-dvoglavi model (odabir poteza i evaluacija pozicija), zaseban evaluacioni model sa minimax algoritmom, model zasnovan na MCTS (Monte Carlo Tree Search) sa samo-igrom i na kraju NNUE (Efficiently Updatable Neural Network). Nijedan od modela nema prethodno znanje o pravilima šaha. Tokom rada korišćena je kombinacija javno dostupne baze podataka partija odigranih na sajtu Lichess.org4, baza podataka majstorskih partija, kao i generisanih pozicija od strane modela tokom igre sam protiv sebe.
2. Metod
2.1. Skup podataka
Osnova svakog projekta iz veštačke inteligencije jeste dobar skup podataka. Za potrebe šahovske VI-e prikupljeni su podaci iz tri izvora. Prvi izvor podataka bio je baza majstorskih partija4 sa Lichess platforme. Budući da se šahovske partije sastoje iz više pozicija (stanja na tabli), one su podeljenje u zasebne pozicije kojih je na kraju bilo oko milion. Ispostavilo se da je to premalo pozicija, te su uzete partije sa iste platforme, ali iz 2023. godine. Partije su filtrirane po rejtingu, a zadržane samo one od igrača čiji je ELO (metrika šahovske veštine) >2000 i podeljene na pozicije, tako da ukupan broj pozicija iznosi oko 6,7 miliona pozicija. Treći izvor podataka je bio uzet sa GitHub stranice projekta AlphaZero2, ali su oni bili zapakovani u zatvoreni fajl sistem .bagz koji nije bilo moguće dešifrovati.
2.2. Kodiranje informacija sa šahovske table
Pre korišćenja neuralnih mreža, neophodno je kodirati pozicije i poteze, odnosno prevesti ih u brojeve.
2.2.1. Kodiranje table
Dve metode kodiranja šahovske table su korišćene.
1. Pojednostavljena AlphaZero metoda2:
Pozicija figura na tabli se kodira kao tenzor dimenzija $20 \times 8 \times 8$. Postoji 6 tipova figura u šahu (pijun, top, skakač, lovac, dama i kralj) koje mogu pripadati belom ili crnom igraču, a pored pozicija figura kodiraju se i 8 meta-podataka o poziciji: čiji je potez, mogućnost male i velike rokade za oba igrača, mogućnost an pasana, pravilo 50 poteza5 i ukupan broj poteza. AlphaZero pored navedenog, u svom kodiranju sadrži poslednjih 7 pozicija u igri. Kako bi se umanjila kompleksnost kodiranja i načina pravljenja podataka, odlučeno je da se koristi samo trenutna pozicija.
| Indeks prve dimenzije | Enkodirana informacija |
|---|---|
| 0-11 | Pozicije figura na tabli |
| 12 | Čiji je potez |
| 13 | Mogućnost male rokade za belog |
| 14 | Mogućnost velike rokade za crnog |
| 15 | Mogućnost male rokade za crnog |
| 16 | Mogućnost velike rokade za crnog |
| 17 | Da li postoji legalan an pasan |
| 18 | Pravilo 50 poteza |
| 19 | Ukupan broj poteza / 100 |
2. HalfKP metoda:
Za NNUE mrežu korišćen je način kodiranja definisan specijalno za nju. Takozvani HalfKP6 (Half King-Piece) način kodiranja pozicije, kao što samo ime kaže, gleda odnos pozicije kralja igrača koji je na potezu, i pozicije svakog od 10 preostalih figura na tabli (izuzimajući kraljeve). Pozicija se na takav način kodira u niz dugačak 40960 ($=64 \times 64 \times 10$) bitova, prva dimenzija govori o poziciji kralja, druga o poziciji figure, i treća o tipu figure. Ako se posmatra početna pozicija u šahu, to u praksi izgleda ovako:
Svoj kralj na a1, svoj pijun na a1: 0
Svoj kralj na a1, svoj pijun na a2: 0
…
Svoj kralj na e1, svoj pijun na a2: 1
Svoj kralj na e1, svoj pijun na a3: 0
…
itd.
Iako je ova metoda kodiranja pozicije pre svega zasnovana na igri šogi, gde su pravila znatno drugačija od šaha, u praksi je primećeno da odlično radi i za šah. Mogu se primetiti par svojstava koje su zgodne za šah.
-
Pozicije koje se ogledaju u ogledalu imaju iste ulazne vrednosti, jer se posmatra pozicija iz perspektive igrača koji je na potezu, bez obzira na boju. Ovo svojstvo biće iskorišćeno kasnije.
-
U otvaranju i središnjici kralj se u poređenju sa ostalim figurama pomera veoma retko, tako da se jednim potezom menja samo nekoliko bitova u ulazu. Na primer, uzimajući početnu poziciju i prvi potez skakač c3, potrebno je samo promeniti sledeće bitove:
- Svoj kralj na e1, svoj skakač na b1: 1 → 0
- Svoj kralj na e1, svoj skakač na c3: 0 → 1
- Protivnički kralj na e8, svoj skakač na b1: 1 → 0
- Protivnički kralj na e8, svoj skakač na c3: 0 → 1
Ovo je razlog iza imena NNUE, odnosno Efficiently Updatable Neural Network.
2.2.2. Kodiranje poteza
Korišćen je način kodiranja poteza koji je koristio Gugl tokom svog razvoja AlphaZero2, a to je tenzor dimenzija $8 \times 8 \times 73$. Posmatra se sa kog polja „započinje potez”, dakle $8 \times 8$ mogućih polja. Pored toga, prvih 56 ravni treće dimenzije predstavljaju teoretski moguće poteze „kao kraljica”, sledećih 8 predstavljaju teoretski moguće poteze „kao skakač”, i poslednjih 9 moguće podpromocije, u skakača, lovca, ili topa. Važno je napomenuti da se potezi lovca, topa ili kralja mogu predstaviti u prvih 56 ravni.
2.3. Modeli
Razvijeno je i implementirano 5 različitih modela za svrhu ovog projekta. U pojedinim modelima, izlaz mreže predstavlja polisu, odnosno odgovor na pitanje koji je najbolji potez za datu poziciju, dok je u ostalim evaluacija pozicije, tj. brojevna vrednost u intervalu [-1, 1]. Ako je evaluacija pozitivna, to znači da je beli igrač u prednosti, obrnuto za crnog igrača. Apsolutna vrednost evaluacije predstavlja koliko je taj igrač u prednosti.
Nijedan od modela nema prethodno znanje o pravilima šaha, već samo na osnovu podataka podešava parametre mreže i na takav način uči da igra šah.
2.3.1. ResNet model
ResNet model koristi rezidualne blokove7.
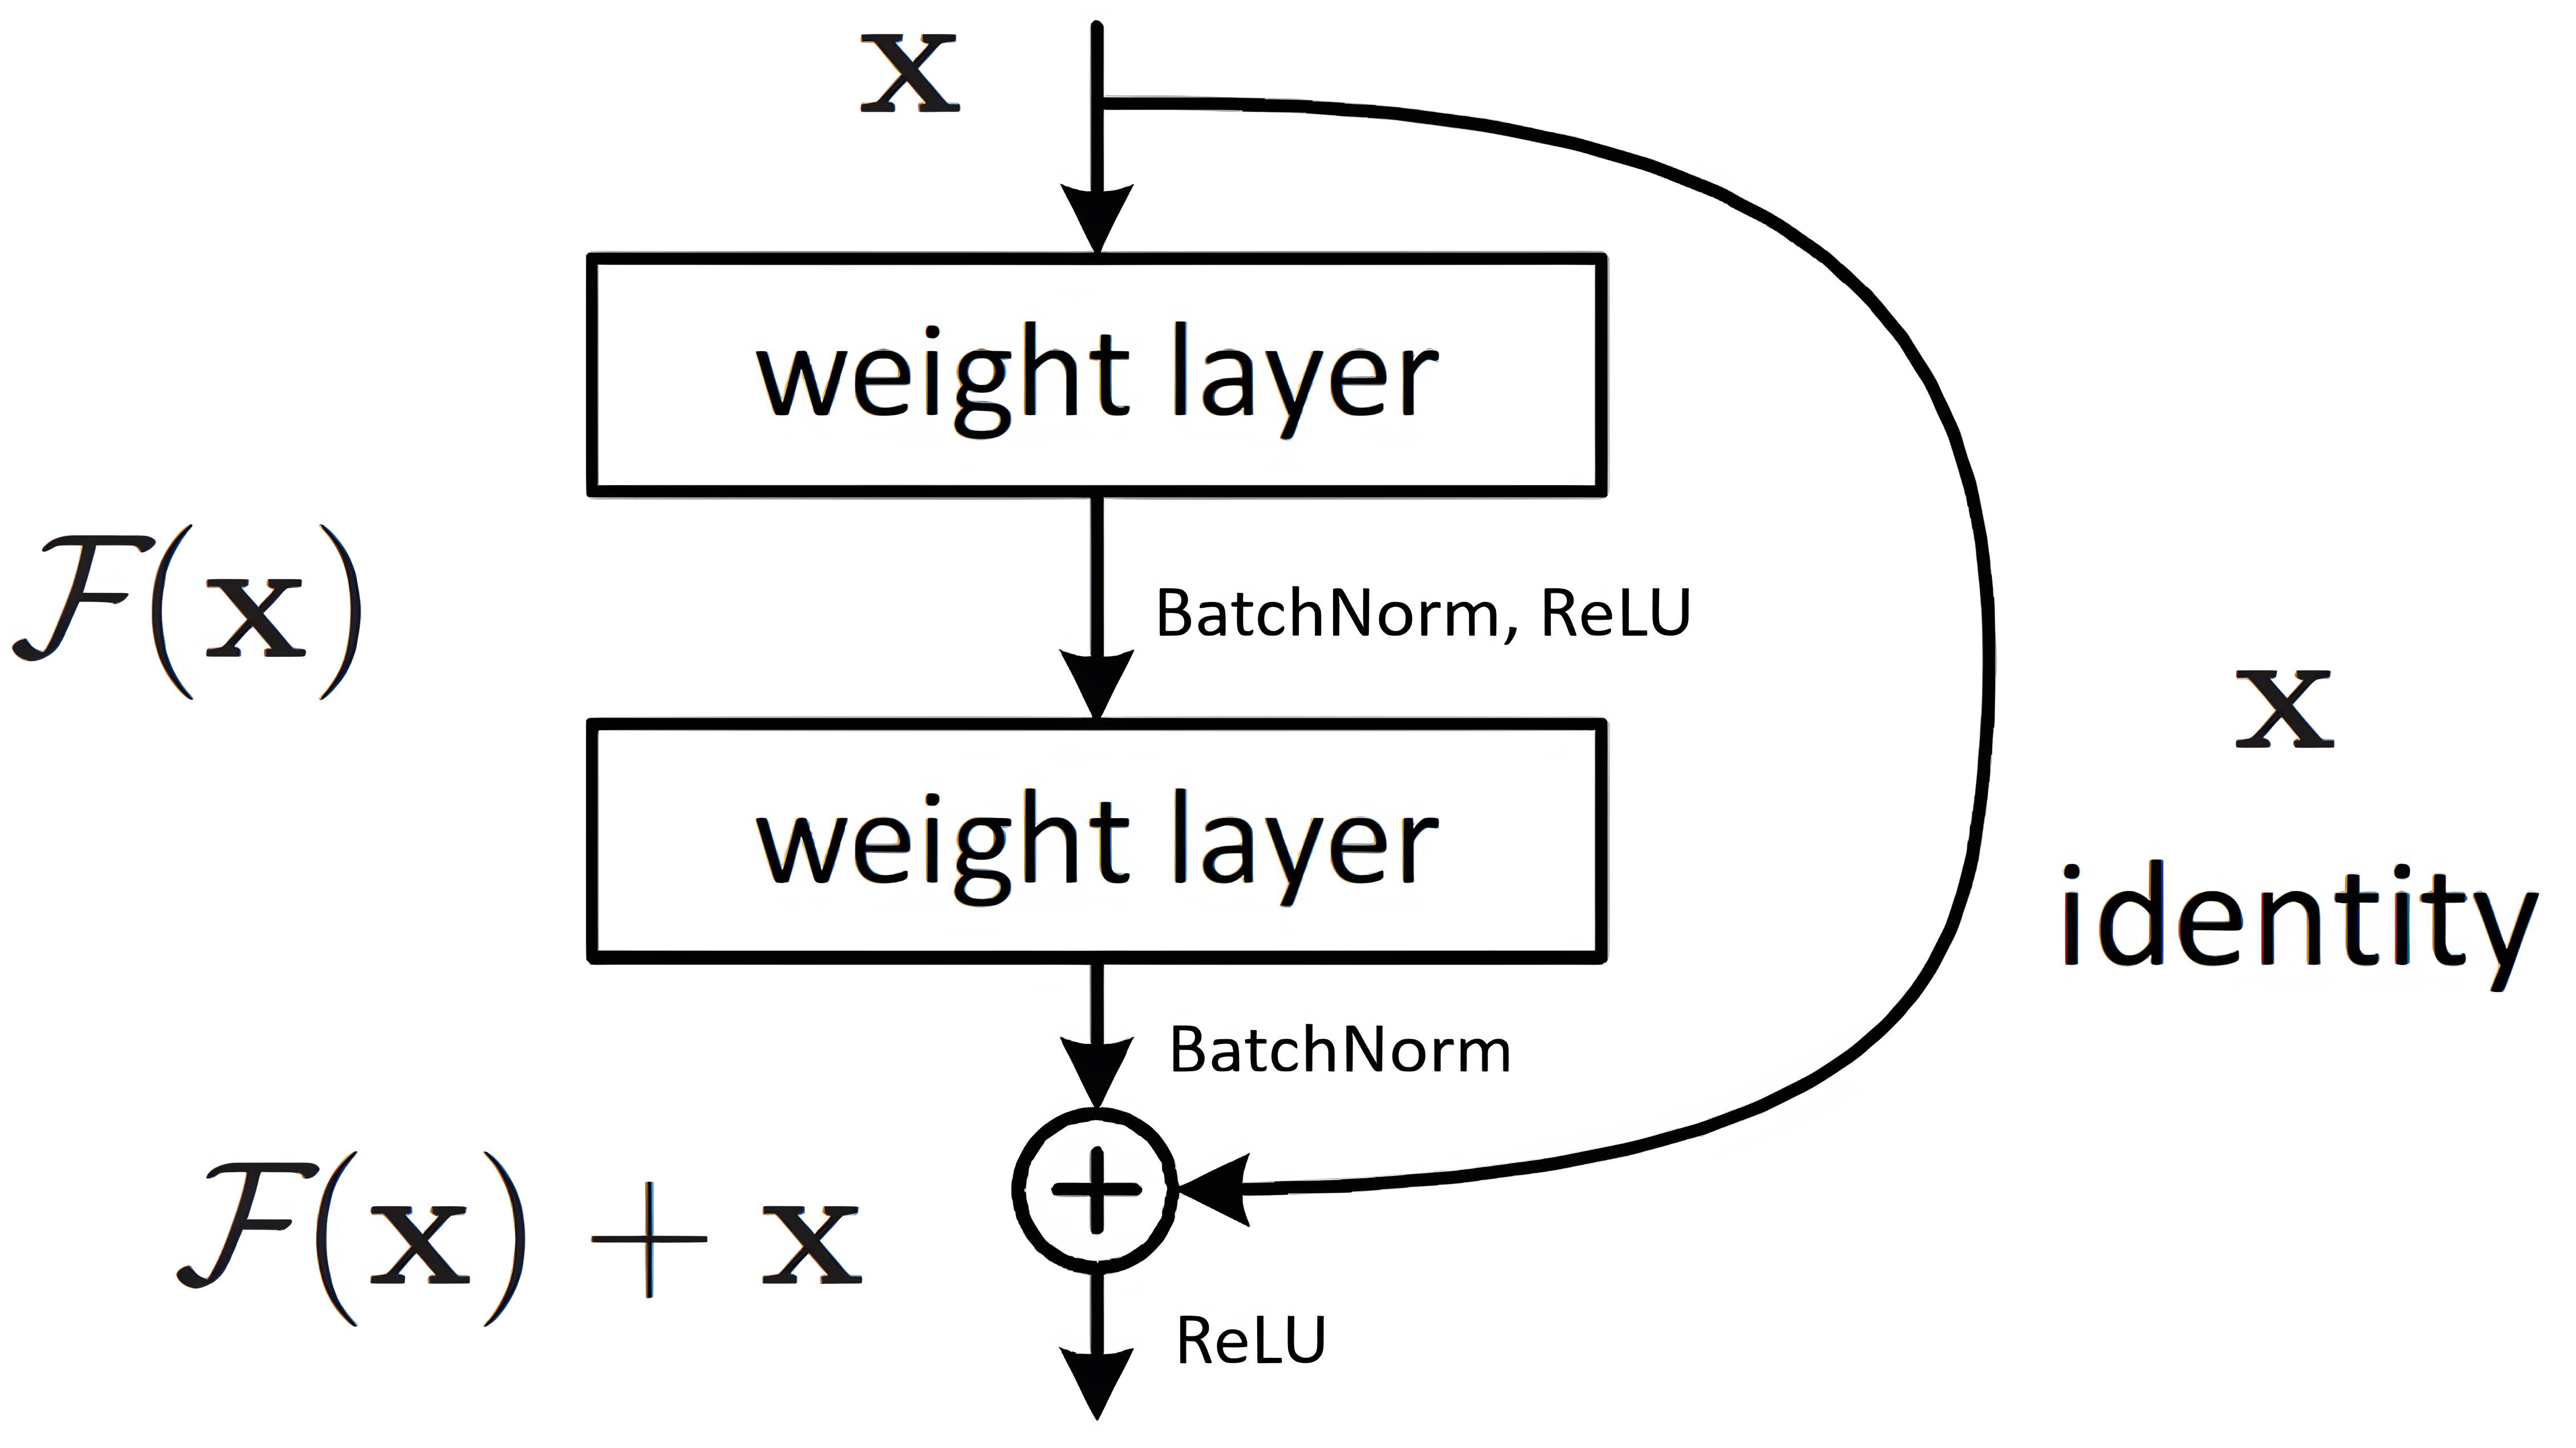
Na slici 1 se može videti kako funkcioniše jedan rezidualan blok. Nakon više gusto povezanih slojeva i njihovih aktivacionih funkcija, njihov krajnji izlaz se sabira sa ulazom i prosleđuje sledećem sloju.
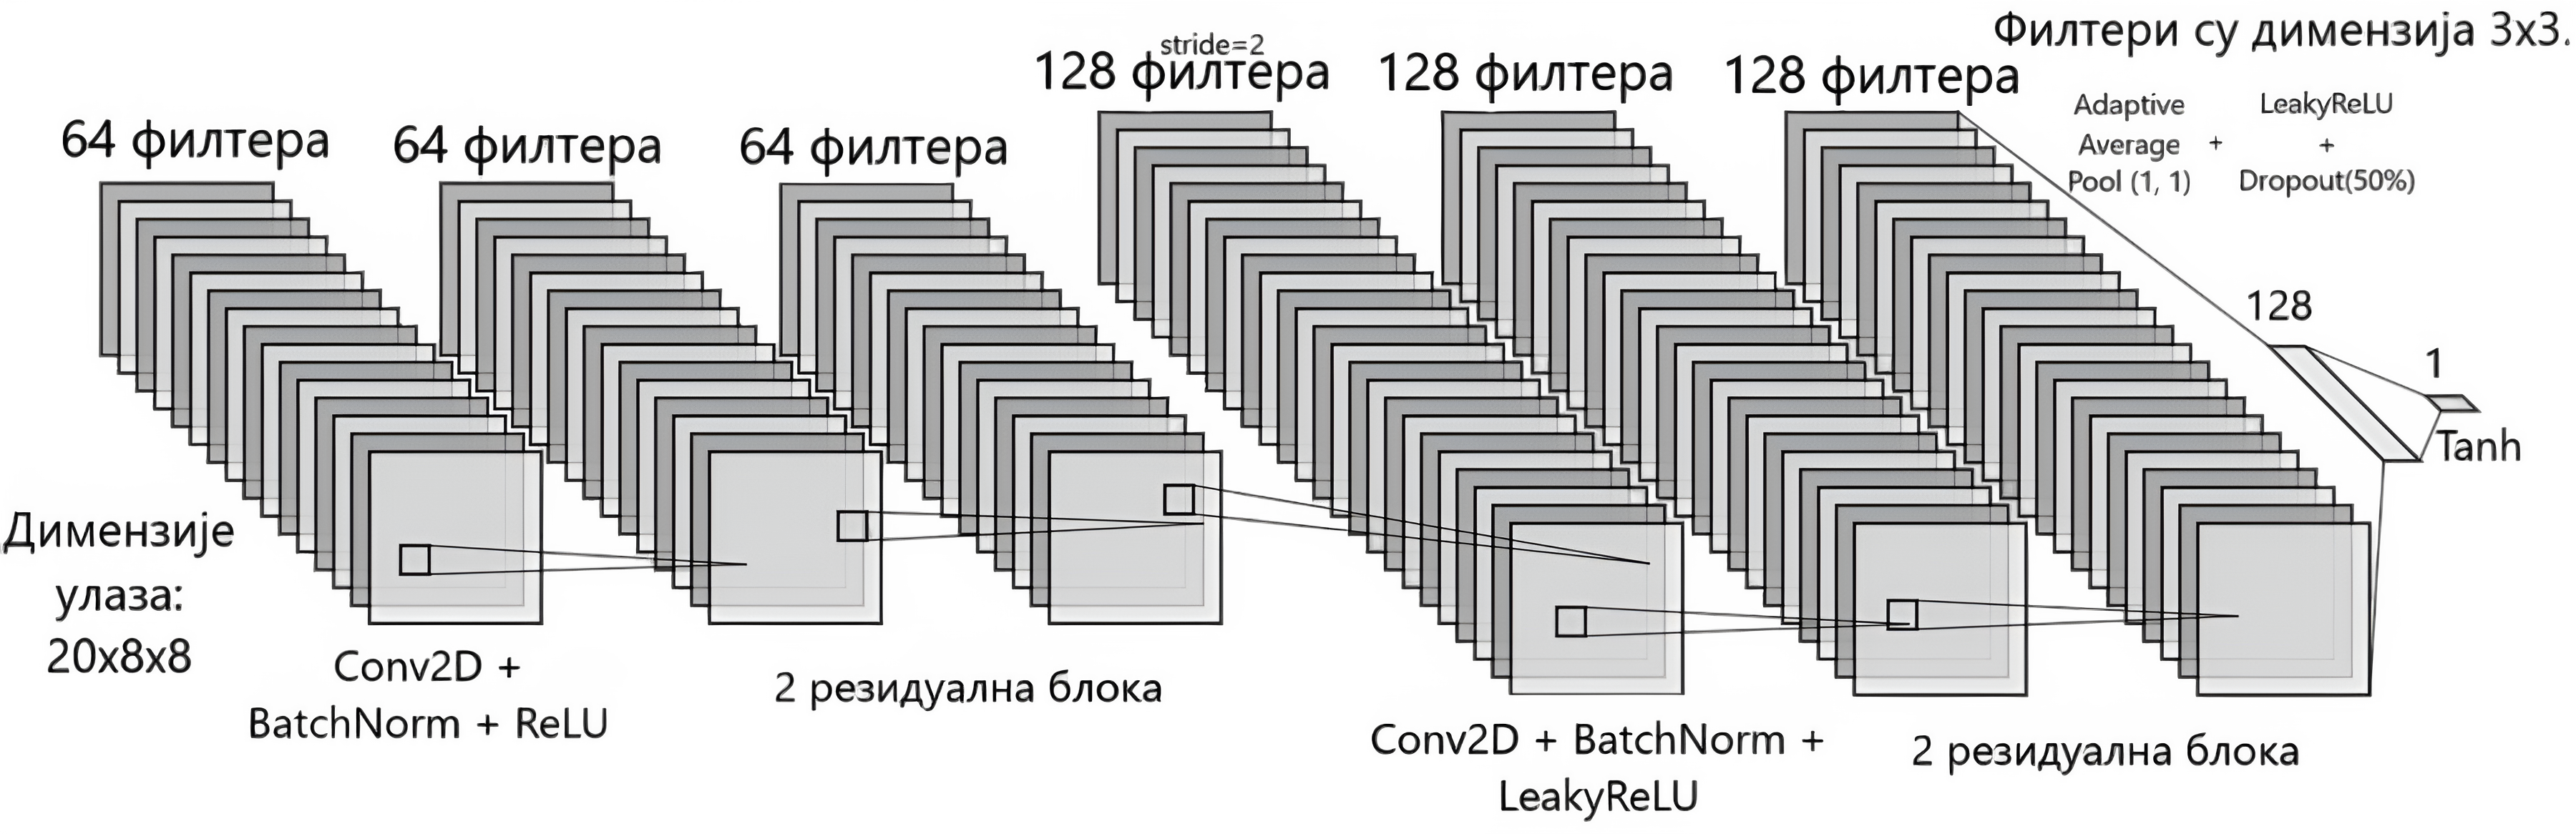
Motivacija iza korišćenja rezidualnih blokova jeste sprečavanje problema nestajućih gradijenata8 gde poslednji slojevi mreže veoma malo utiču na sam izlaz. Kompletna arhitektura mreže se može videti na slici 2.
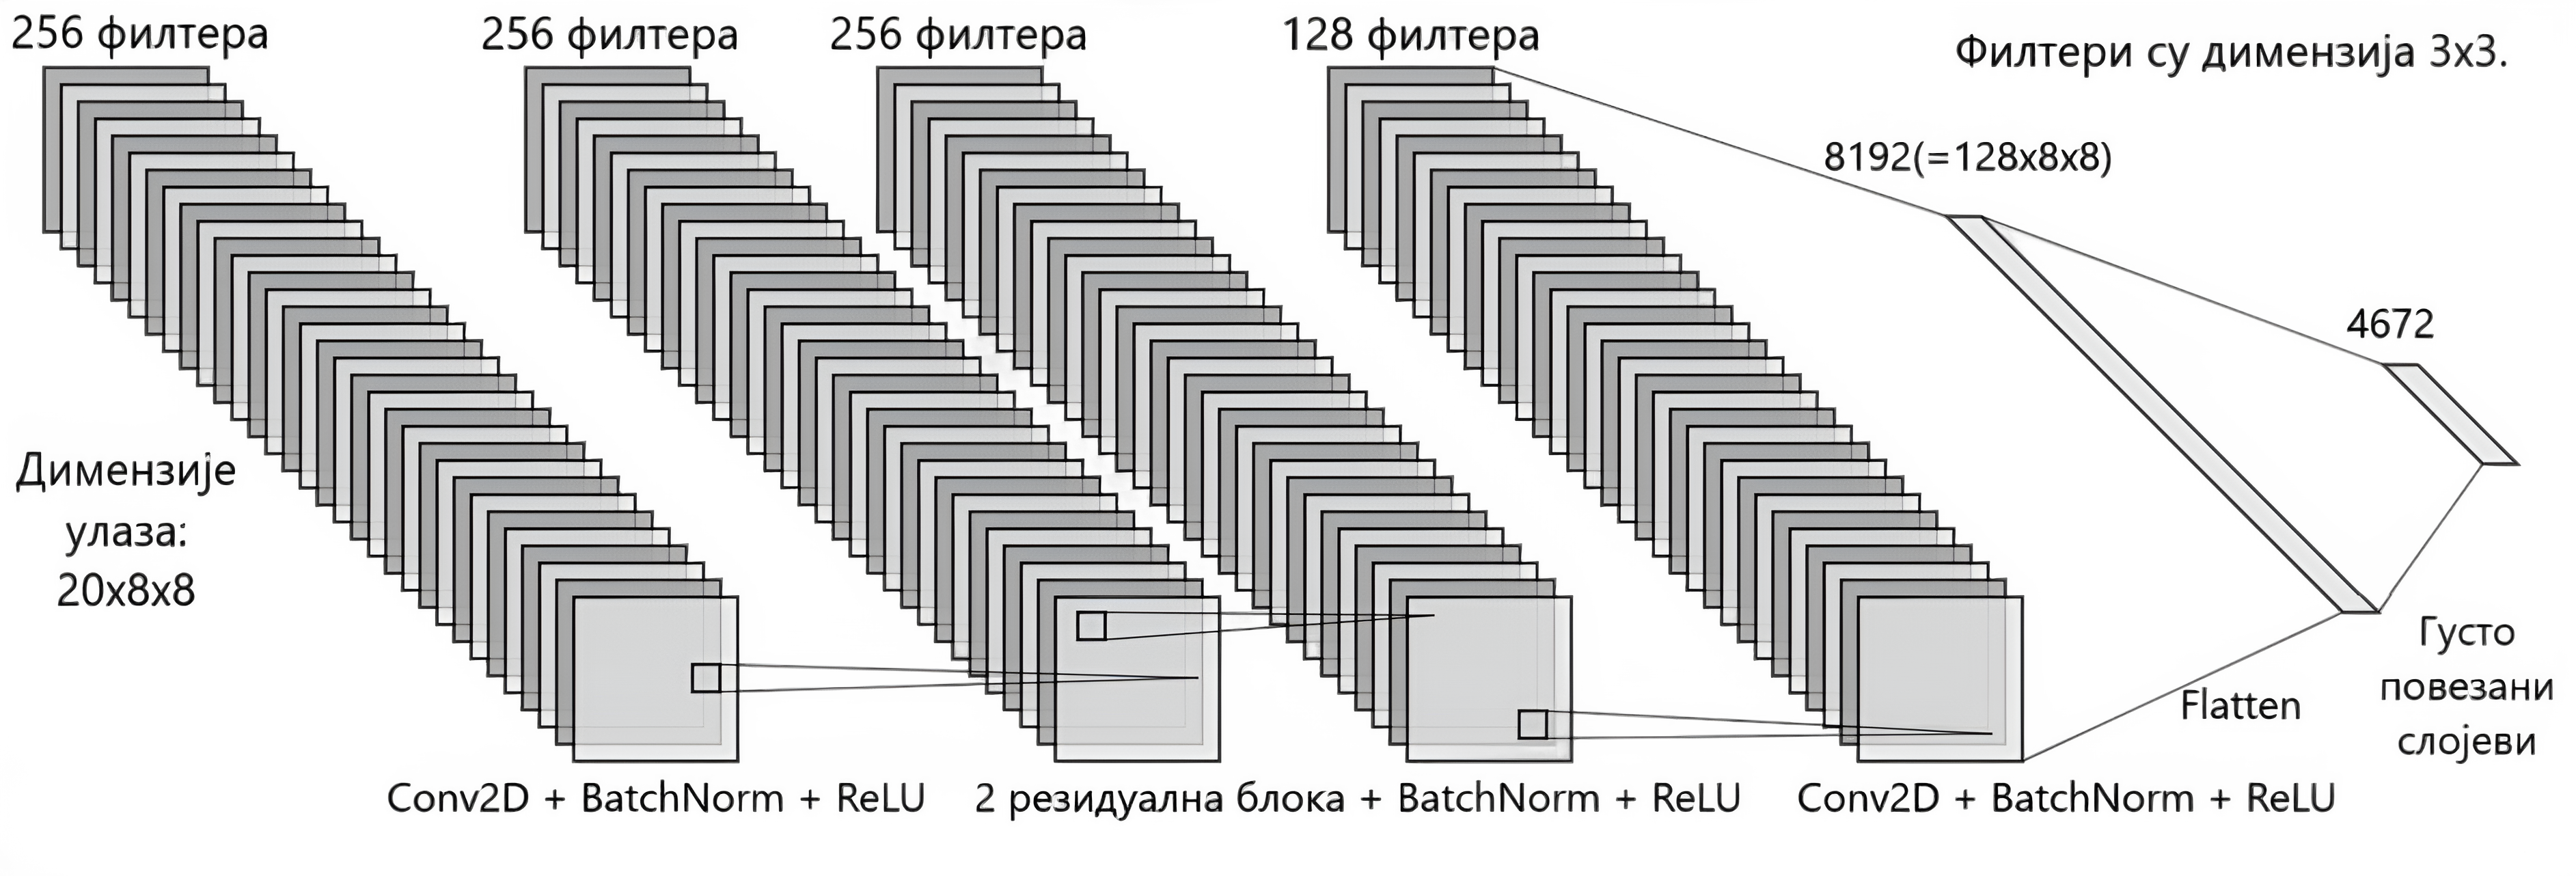
Ulaz je kodirana pozicija, a izlaz predstavlja niz od 4672 neurona koji predstavlja verovatnoće za svaki od mogućih poteza da je najbolji. Model odigrava potez sa najvećom verovatnoćom. Ako taj potez nije legalan, bira se sledeći najbolji, sve dok se ne dođe do legalnog poteza.
2.3.2. Model „Dve glave”
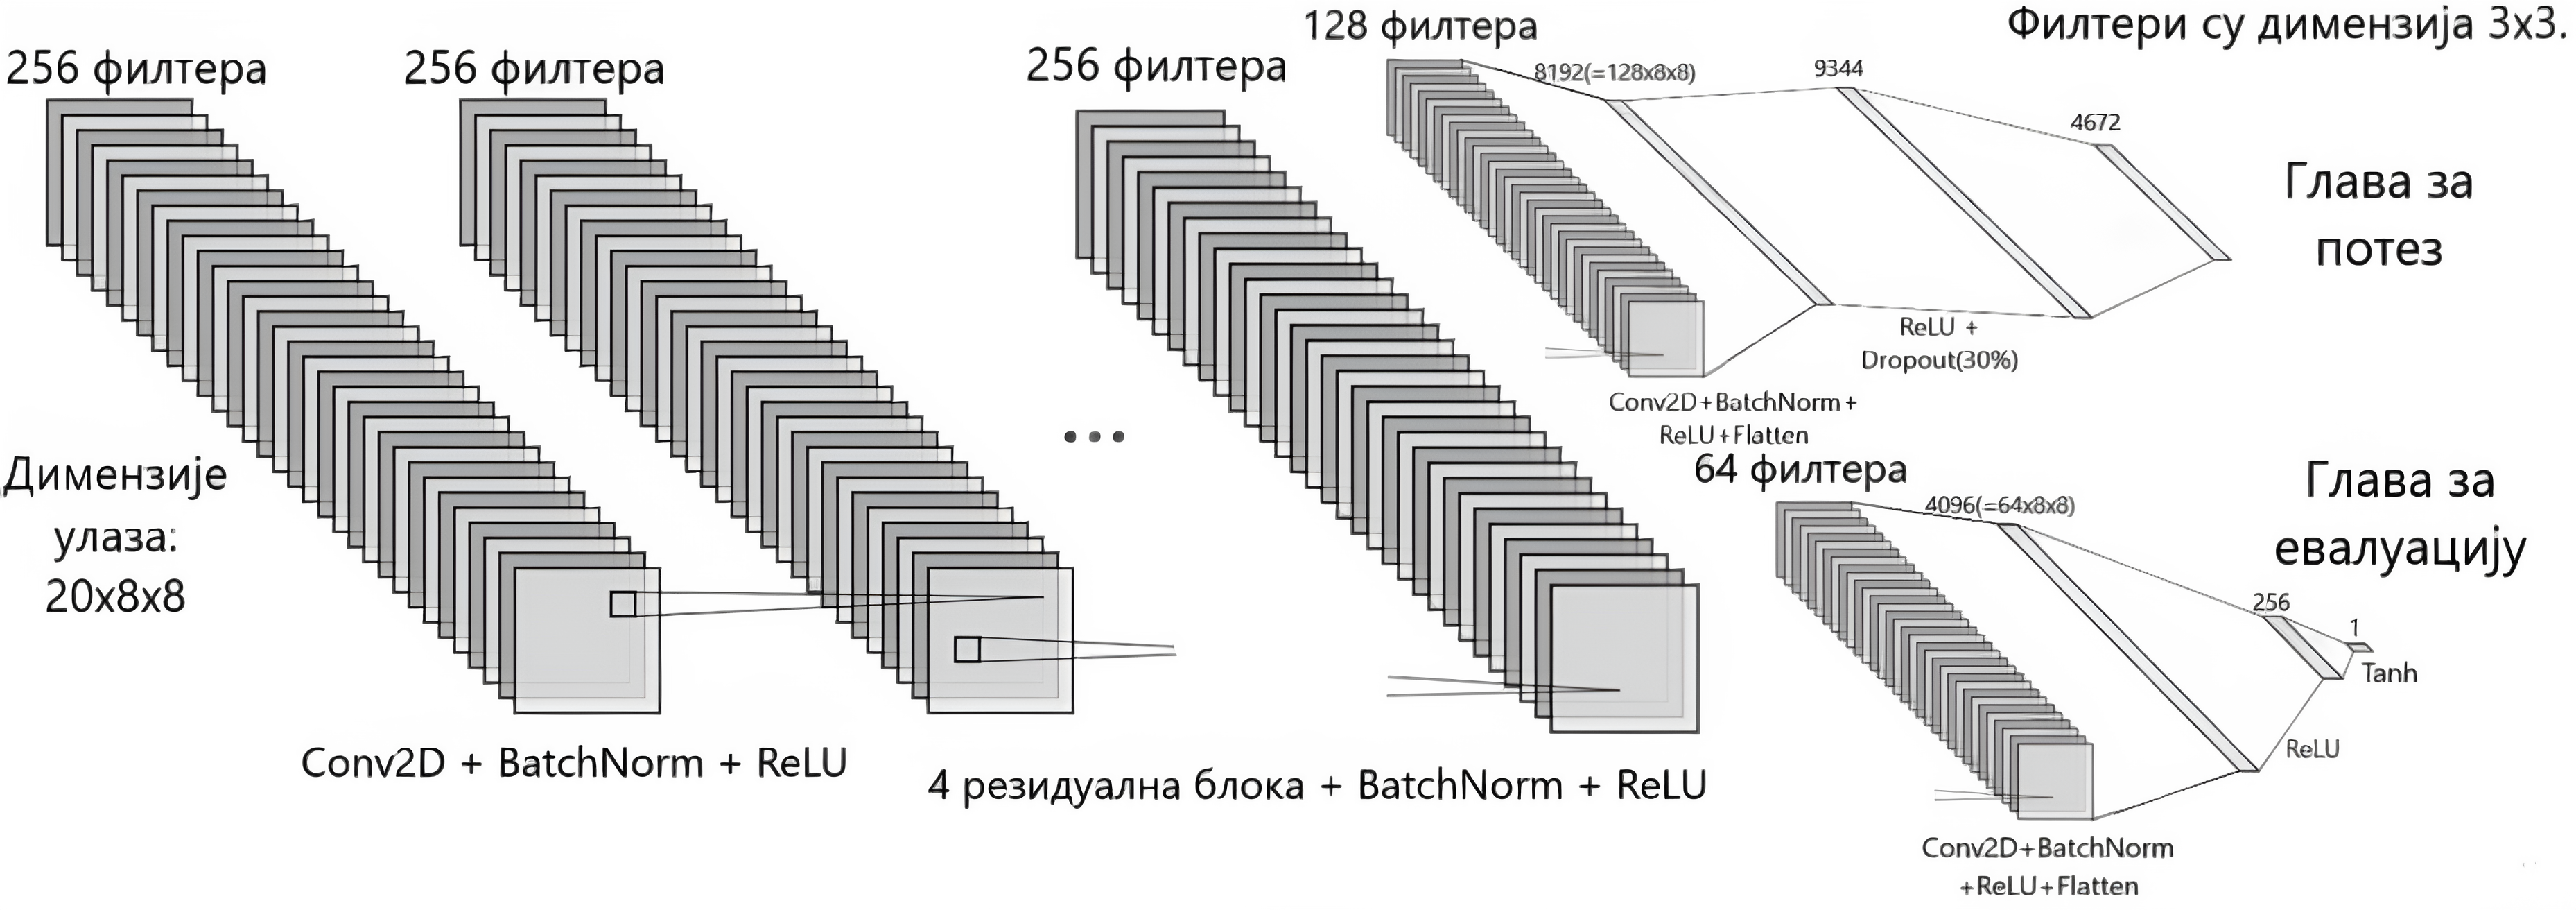
Arhitektura ovog modela nije znatno različita od mreže ResNet. I dalje se koriste rezidualni blokovi, ali glavna razlika je u tome što se sada glavni deo mreže račva na dva tipa izlaza: polisu, odnosno najbolji potez, i evaluaciju pozicije.
2.3.3. MCTS / samoigra
AlphaZero je mreža zasnovana na ovoj arhitekturi, i glavna inspiracija iza ovog projekta.
Glavni problem za svakog modela koji igra šah jesu upravo velike količine podataka koje su neophodne za kvalitetno i smisleno učenje. Ovaj pristup pokušava da reši taj problem na vrlo, naizgled, očigledan način; to je generisanje trening podataka iz partija u kojima model igra sam protiv sebe. Algoritam koji je u centru ovog modela jeste Monte Karlo pretraga stabla9. Čvorovi stabla predstavljaju pozicije na tabli, a ivice odigrane poteze. Postoje 4 faze pretrage, odnosno simulacije, koje se ponavljaju određeni broj puta.
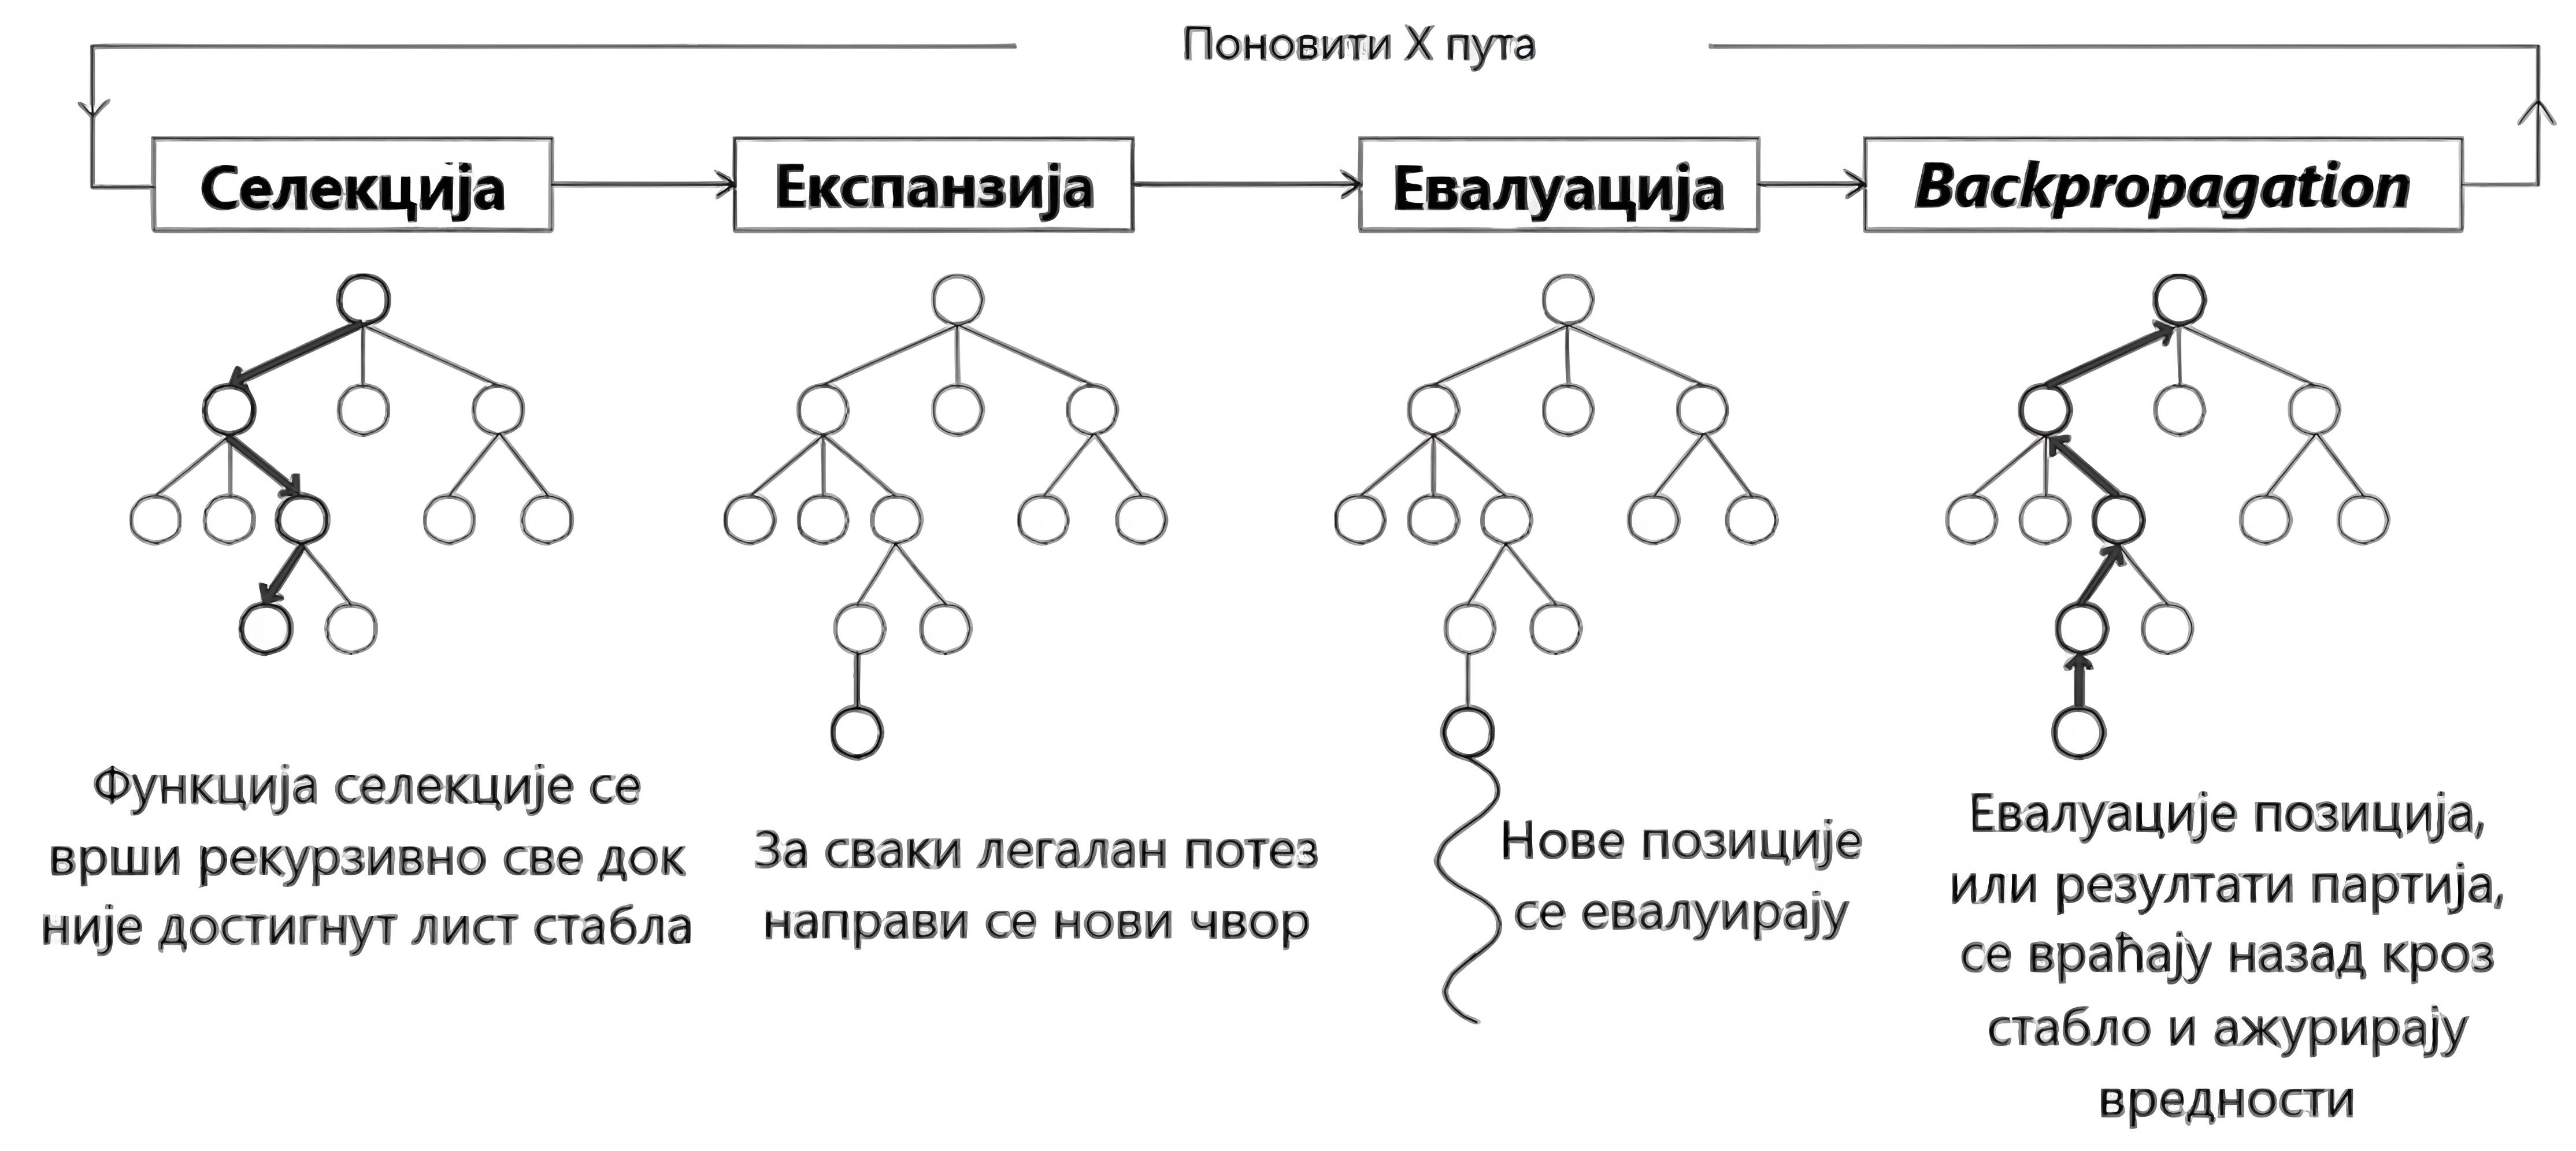
Selekcija
Ova faza predstavlja prolazak od korena stabla (pozicija nad kojoj se vrši evaluacija), sve do lista stabla. Ovaj proces se odvija tako što se bira najbolja ivica za svaki posećeni čvor. Svaka ivica poseduje UCB (Upper Confidence Bound) vrednost, kojom se određuje najbolja ivica. UCB vrednost ivice je zbir vrednosti eksploatacije i vrednosti istraživanja. Naravno, poželjno je eksploatisati poteze koji su već poznati da su dobri, a u isto vreme postoji mogućnost postojanja još boljeg poteza koji nije još pronađen. Vrednost eksploatacije se računa na osnovu Q vrednosti, tj. prosečne vrednosti ivice koja se računa na osnovu evaluacije neuralne mreže. Vrednost istraživanja se računa sledećom formulom:
$$ E = \frac{c \cdot p \cdot v_{parent}}{1 + v_{edge}}, $$
gde je $E$ vrednost istraživanja, $c$ parametar istraživanja (korišćeno je $c = 1$), $p$ izlaz iz neuralne mreže za taj potez, $v_{parent}$ broj posećivanja roditeljskog čvora i $v_{edge}$ broj posećivanja same ivice.
Tokom prolaska, pamti se niz ivica od korena do lista, zarad poslednje faze.
Ekspanzija
Kada je list stabla dostignut, i nije u pitanju kraj partije, on se proširuje, tako što mu se dodaje po ivica za svaki legalan potez u toj poziciji. Neuralna mreža dostavlja verovatnoće za svaki potez.
Evaluacija (simulacija)
U ovoj implementaciji, pošto bi bilo presporo za uslove u kojima je rađeno da se radi klasična nasumična simulacija partije do kraja, se za svaku od novih pozicija prosleđuje evaluacija pozicije neuralne mreže, osim ako je kraj partije u pitanju; u tom slučaju, za pobedu se prosleđuje vrednost od 1, za poraz -1, a za remi 0.
Povratno guranje (Backpropagation)
U ovoj fazi se ažuriraju ivice koji se nalaze u putanji do lista novodobijenim informacijama. Ažuriraju se broj poseta i brojevna vrednost ivica i čvorova. Bitno je napomenuti da je neophodno obrnuti znak nakon svake ivice, kako bi vrednost tačno odražavala perspektivu odgovarajućeg igrača.
Kada se završi određen broj simulacija, u ovom slučaju samo 10, bira se ivica sa najvećim brojem poseta. Korišćen je model „Dve glave”, jer su bili potrebni i evaluacija pozicije i verovatnoće za poteze.
2.3.4. Model ekskluzivne evaluacije
Pošto se pristup baziran na MCTS algoritmu nije pokazao kao dobar zbog hardverskih ograničenosti, sledeći najlogičniji korak je bio uprostiti ga. Pristup koji je zamenio MCTS koristi minimax algoritam sa alfa-beta orezivanjem10 i evaluacionu funkciju kako bi odredio sledeći potez. Za evaluacionu funkciju iskoristili smo model ekskluzivne evaluacije — model koji koristi konvolucione i rezidualne blokove kako bi odredio distribuciju verovatnoće poteza. Ovaj model je treniran tako što mu je data šahovska pozicija i distribucija poteza Stockfish-a na dubini 10, na 10 miliona pozicija. Minimax algoritam funkcioniše tako što jedan igrač pokušava da minimizuje vrednost evaluacije za datu poziciju, a drugi da ga maksimizuje. Simulacijom igre na određenu dubinu može se utvrditi skoro optimalan potez. Alfa-beta orezivanje je dorada ovog pristupa koja dinamički odbacuje određena podstabla stabla svih mogućih poteza i njihovih evaluacija u odnosu na ostale poteze koji su do tad pregledani.
Prilikom implementacije ovog pristupa javila su se dva problema. Prvi problem, u završnicama u kojima ostaje malo figura model nije mogao da vidi sekvence koje vode ka pobedi drugog igrača, ovaj problem je rešen dodavanjem adaptivne dubine koja zavisi od broja figura koje su ostale na tabli. Drugi problem, vreme koje je modelu potrebno da evaluira poziciju je dugo za minimaks algoritam budući da broj mogućih pozicija raste eksponencijalno sa dubinom isto raste i vreme računanja najboljeg poteza. Ovaj problem je delimično rešen implementacijom alfa-beta orezivanja koje orezuje grane stabla mogućih pozicija ako je prethodno utvrćen bolji potez iste dubine.
2.3.5. NNUE (Efikasno ažurirajuća neuralna mreža)
Pored neuobičajenog načina kodiranja pozicije, sama arhitektura mreže6 je poprilično jednostavna.
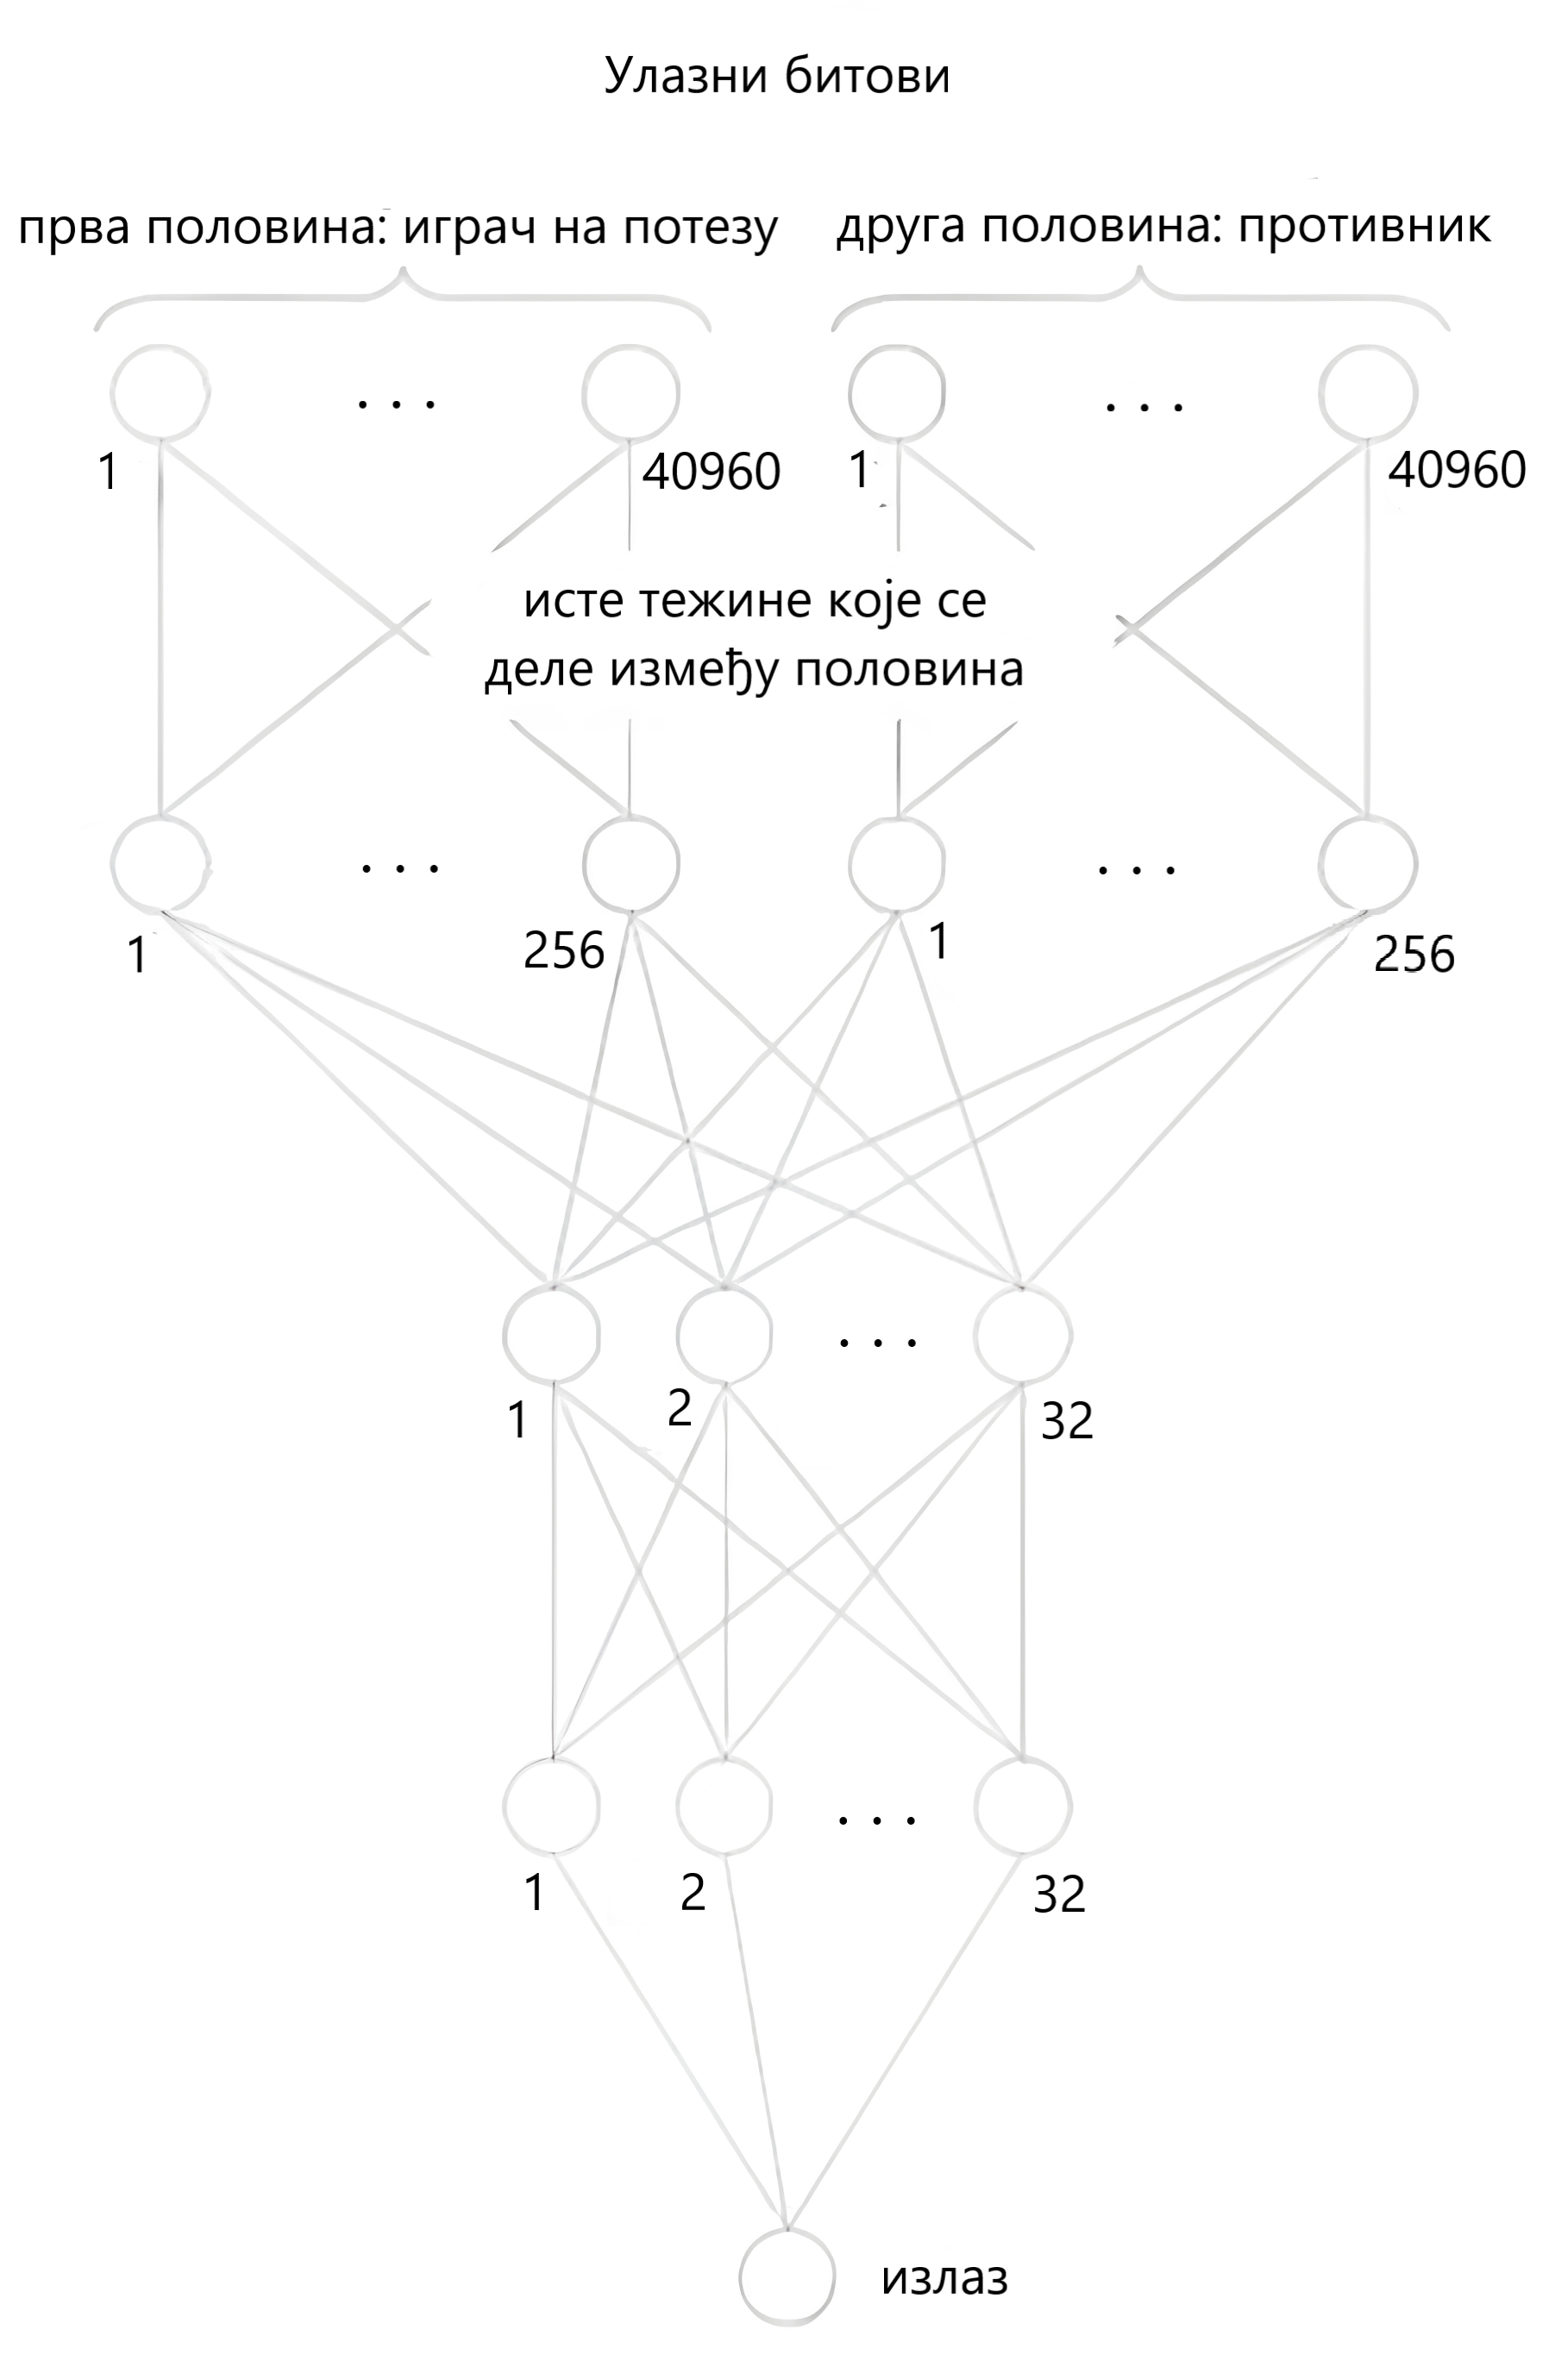
Postoje dve polovine, jedna za stranu koja je na potezu, jedna za protivnika. Svaka od polovina ima za ulaz kodiranu poziciju koja je gusto povezana sa sledećim slojem od 256 neurona. Korisno je to što je moguće koristiti identične težine između ova dva sloja u prvoj i drugoj polovini. Na primer, težina koja povezuje bit „svoj kralj na e1, pijun na a2” sa prvim čvorom u sledećem sloju, je ista kao težina koja povezuje bit „protivnički kralj na e8, protivnički pijun na a7”. Pritom, ako se koriste 8-bitne i 16-bitne vrednosti za parametre neuralne mreže, ovo svojstvo nam omogućuje efikasnije računanje pomoću naprednih CPU instrukcija.
Nakon prvog sloja, dve polovine se spajaju u gusto povezani sloj od 32 neurona, koji je potom gusto povezan sa još jednim slojem od 32. Poslednji sloj se sastoji od jednog neurona i predstavlja evaluaciju pozicije.
Korišćena je ClippedReLU aktivaciona funkcija između svaka dva povezana sloja. Vrednosti manje ili jednake nuli slikaju se u nulu, vrednosti između 0 i 1 se slikaju same u sebe, a vrednosti veće ili jednake od 1 se slikaju u 1.
Za određivanje poteza, korišćen je minimax algoritam, gde beli igrač pokušava da maksimizuje, a crni igrač da minimizuje evaluaciju.
3. Treniranje
Sve mreže, osim MCTS metode, su trenirane na skupu podataka od oko 6,7 miliona šahovskih pozicija. Svaka arhitektura pokazuje stabilnu konvergenciju.
Metoda koja koristi Monte Karlo pretragu stabla se pokazala kao suviše računarski zahtevna, i zbog tog razloga nije bilo moguće adekvatno trenirati tu mrežu.
| Model | ResNet | „Dve glave” | Ekskluzivno evalucioni | NNUE |
|---|---|---|---|---|
| Batch size | $512$ | $512$ | $512$ | $2048$ |
| Stopa učenja | $10^{-3}$ | $10^{-3}$ | $10^{-3}$ | $10^{-3}$ |
| Stopa smanjenja stope učenja | $/$ | $/$ | $10^{-4}$ | $10^{-4}$ |
| Broj epoha | $20$ | $20$ | $15$ | $50$ |
| Optimizator | Adam | Adam | Adam | AdamW |
| Funkcija greške | CrossEntropyLoss | Za polisu: CrossEntropyLoss, za evaluaciju: MSE. Sabiraju se i propagiraju unazad. | MSE | MSE |
| Scheduler | max, patience $= 2$ | max, factor $= 0.5$, patience $= 2$ | $/$ | min, factor $= 0.5$, patience $= 5$ |
4. Rezultati
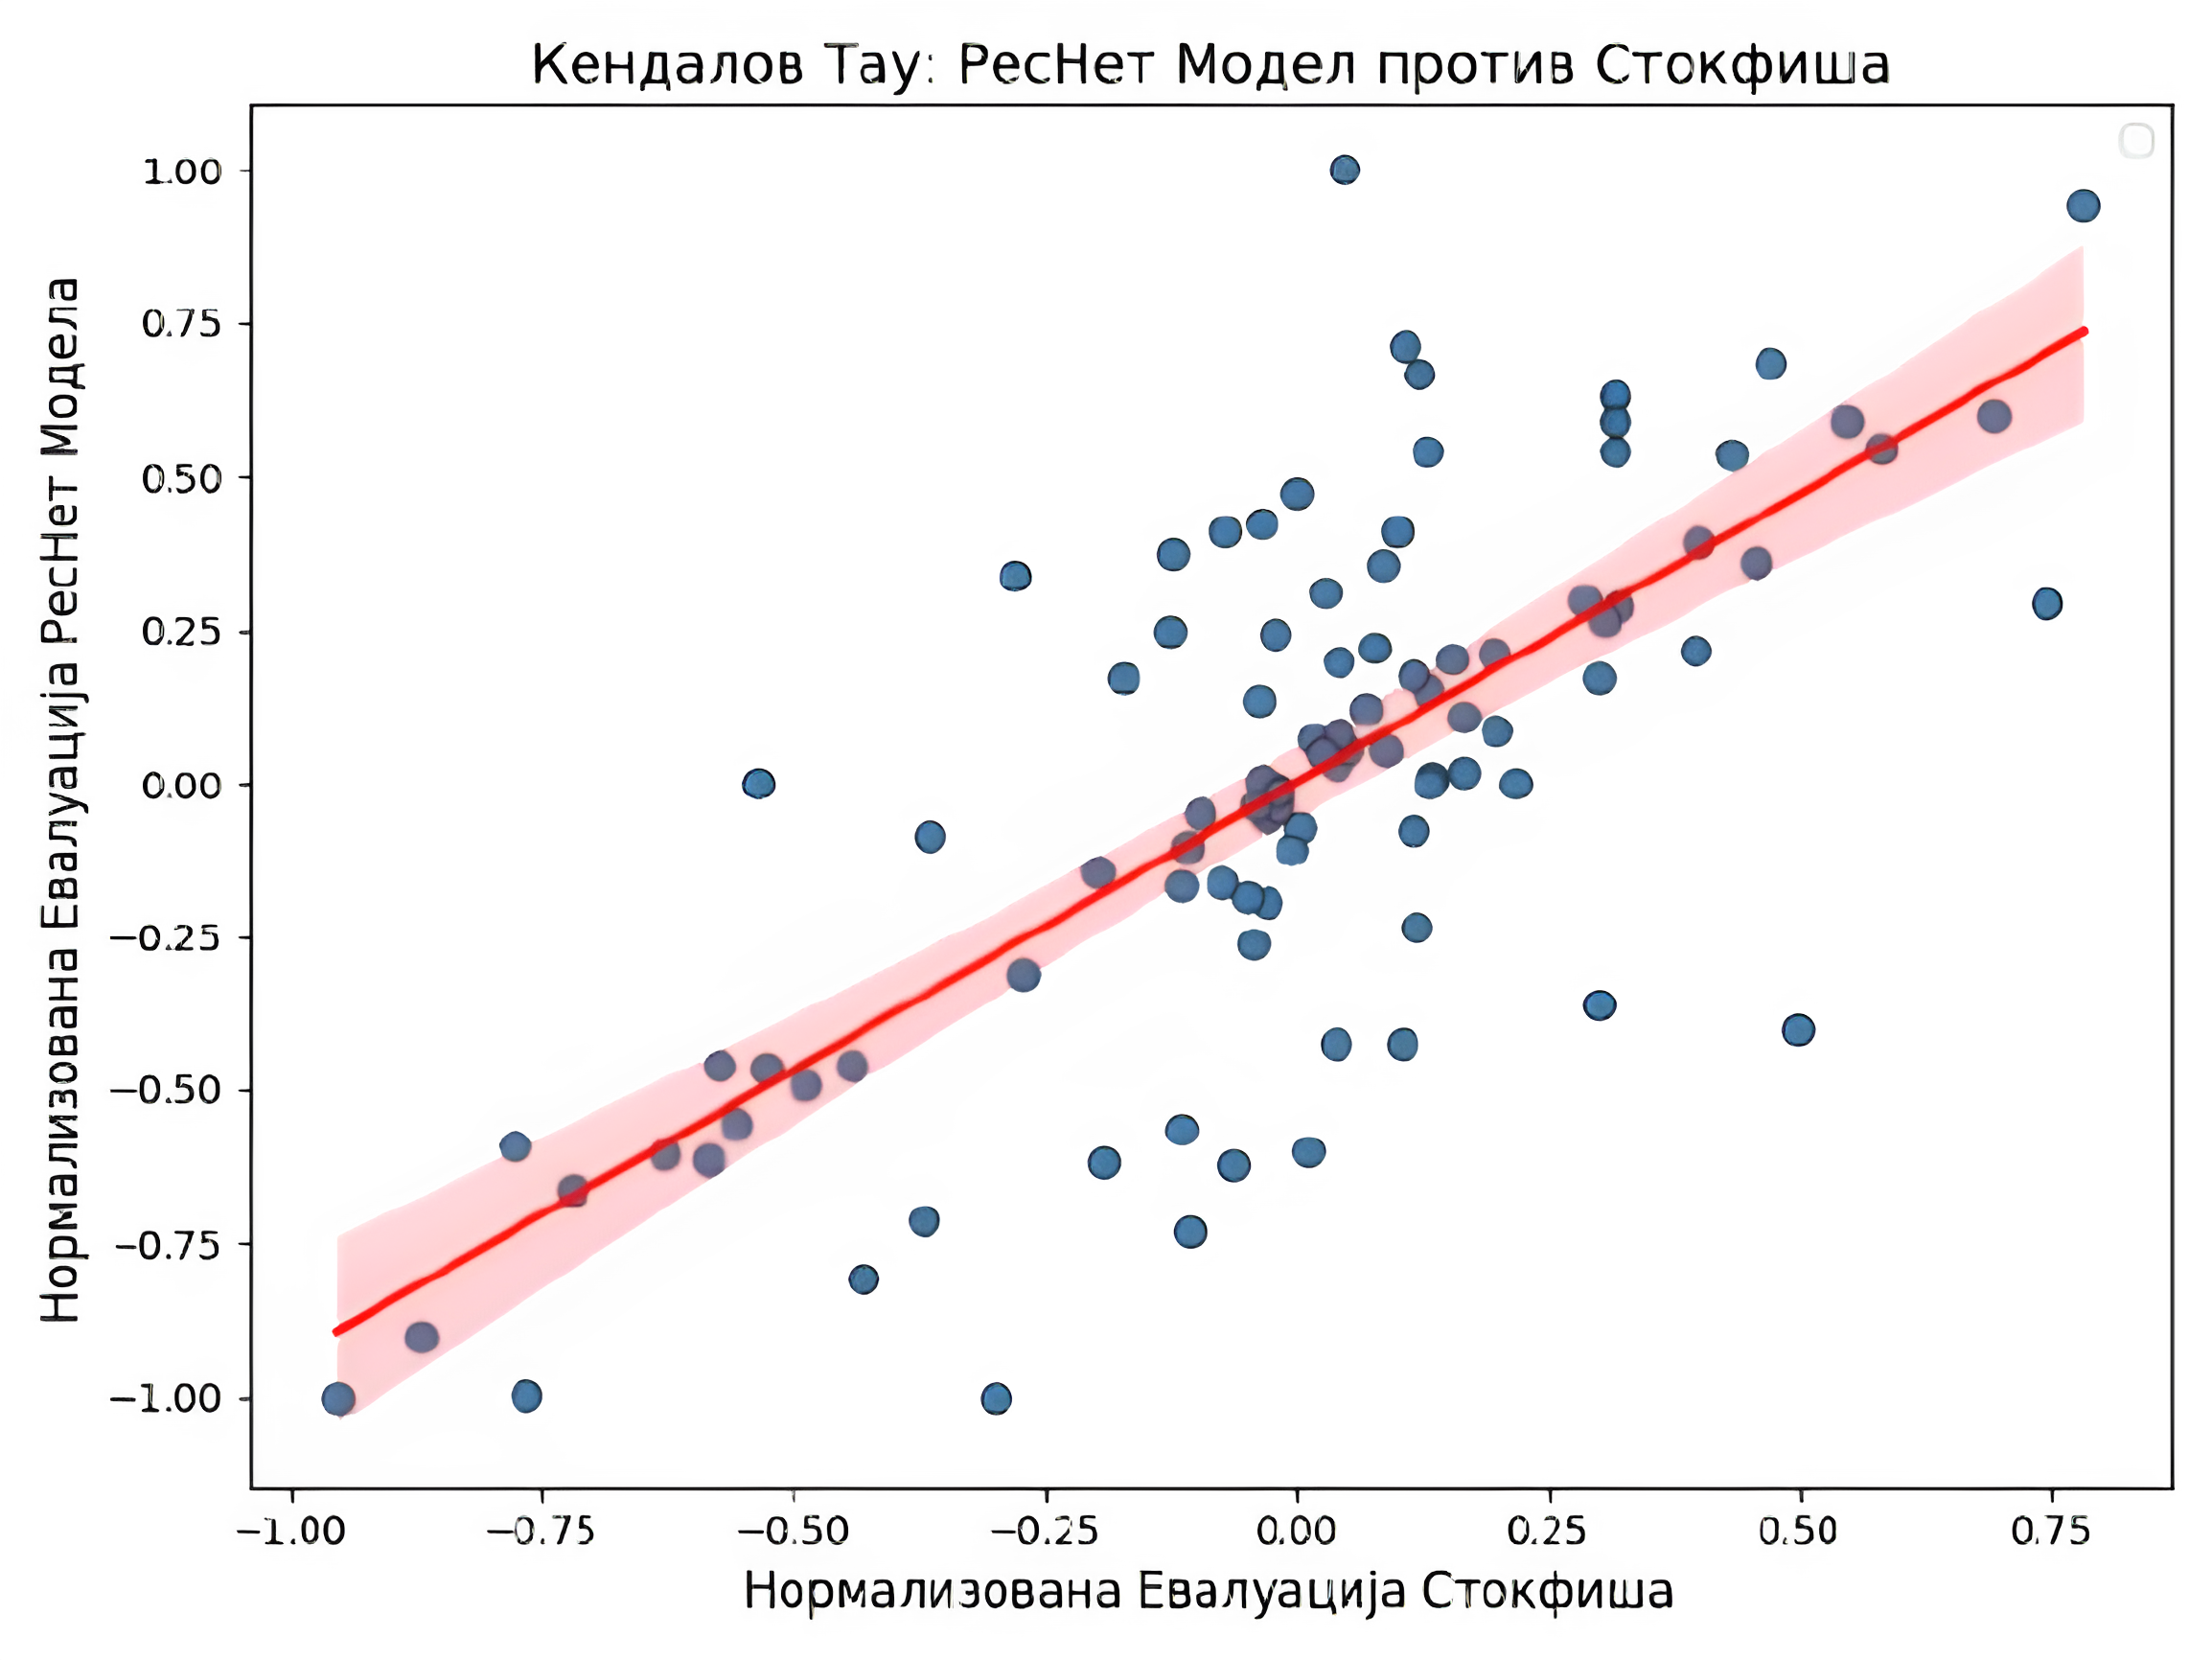
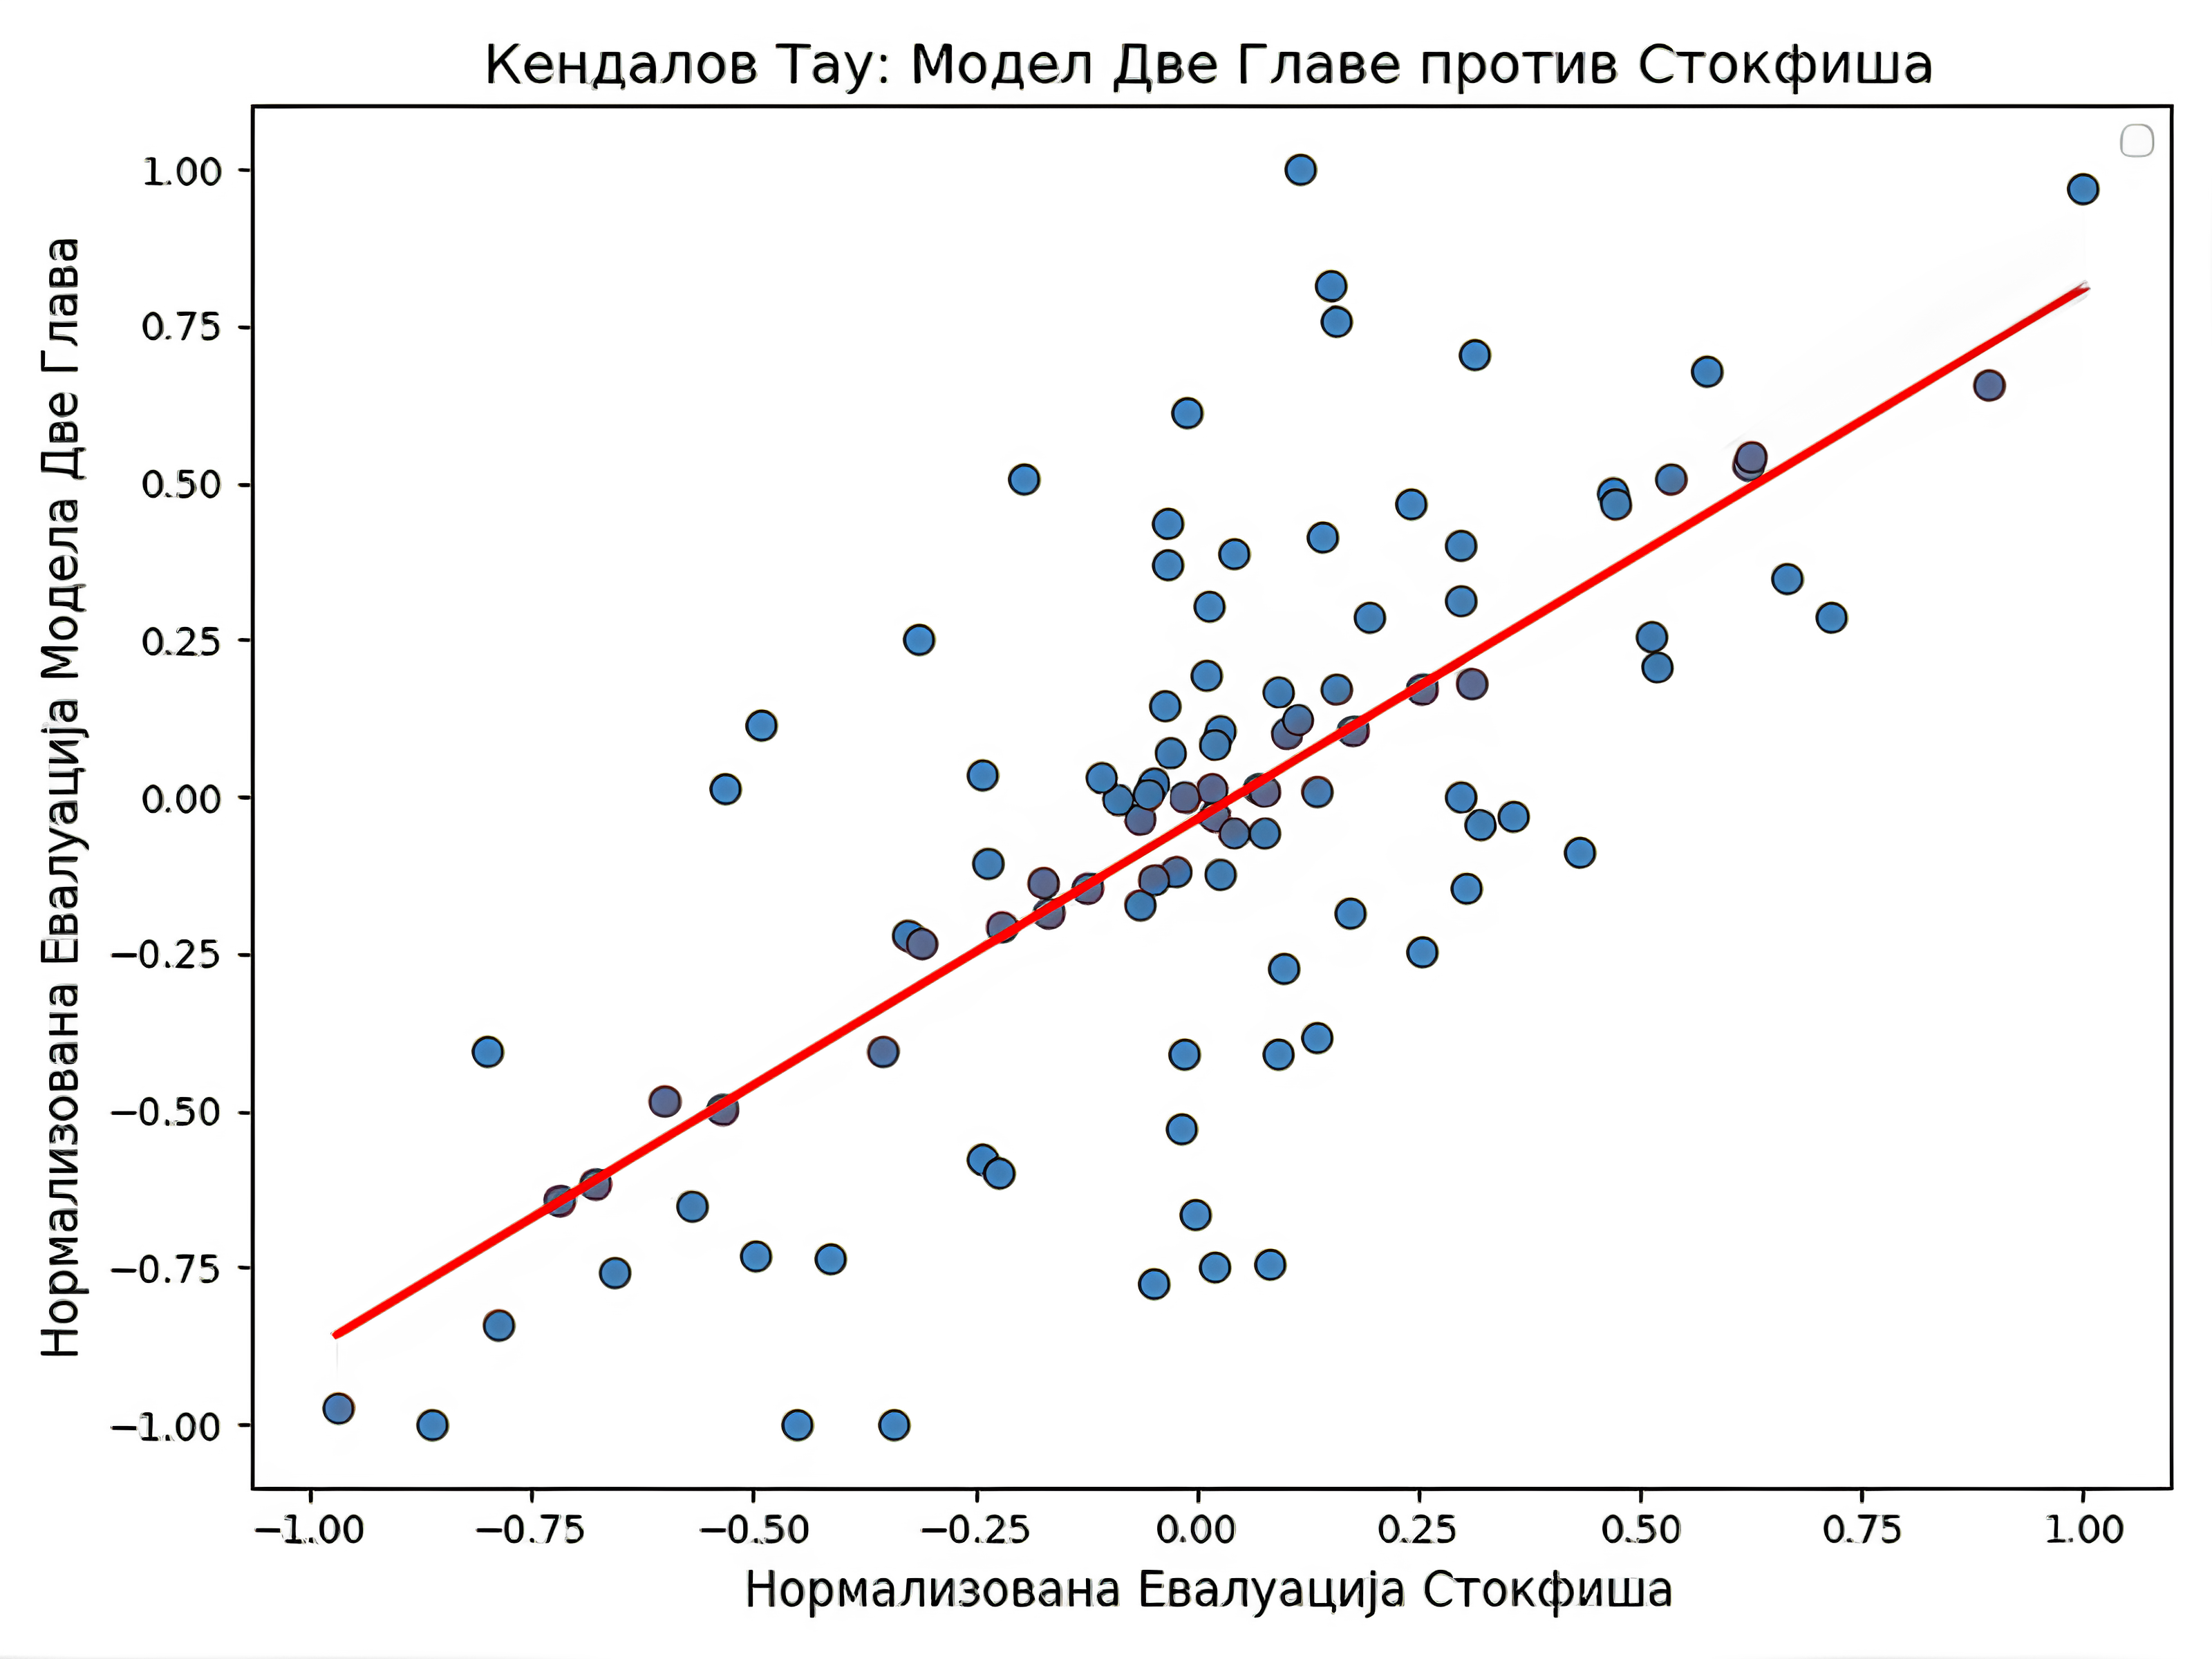
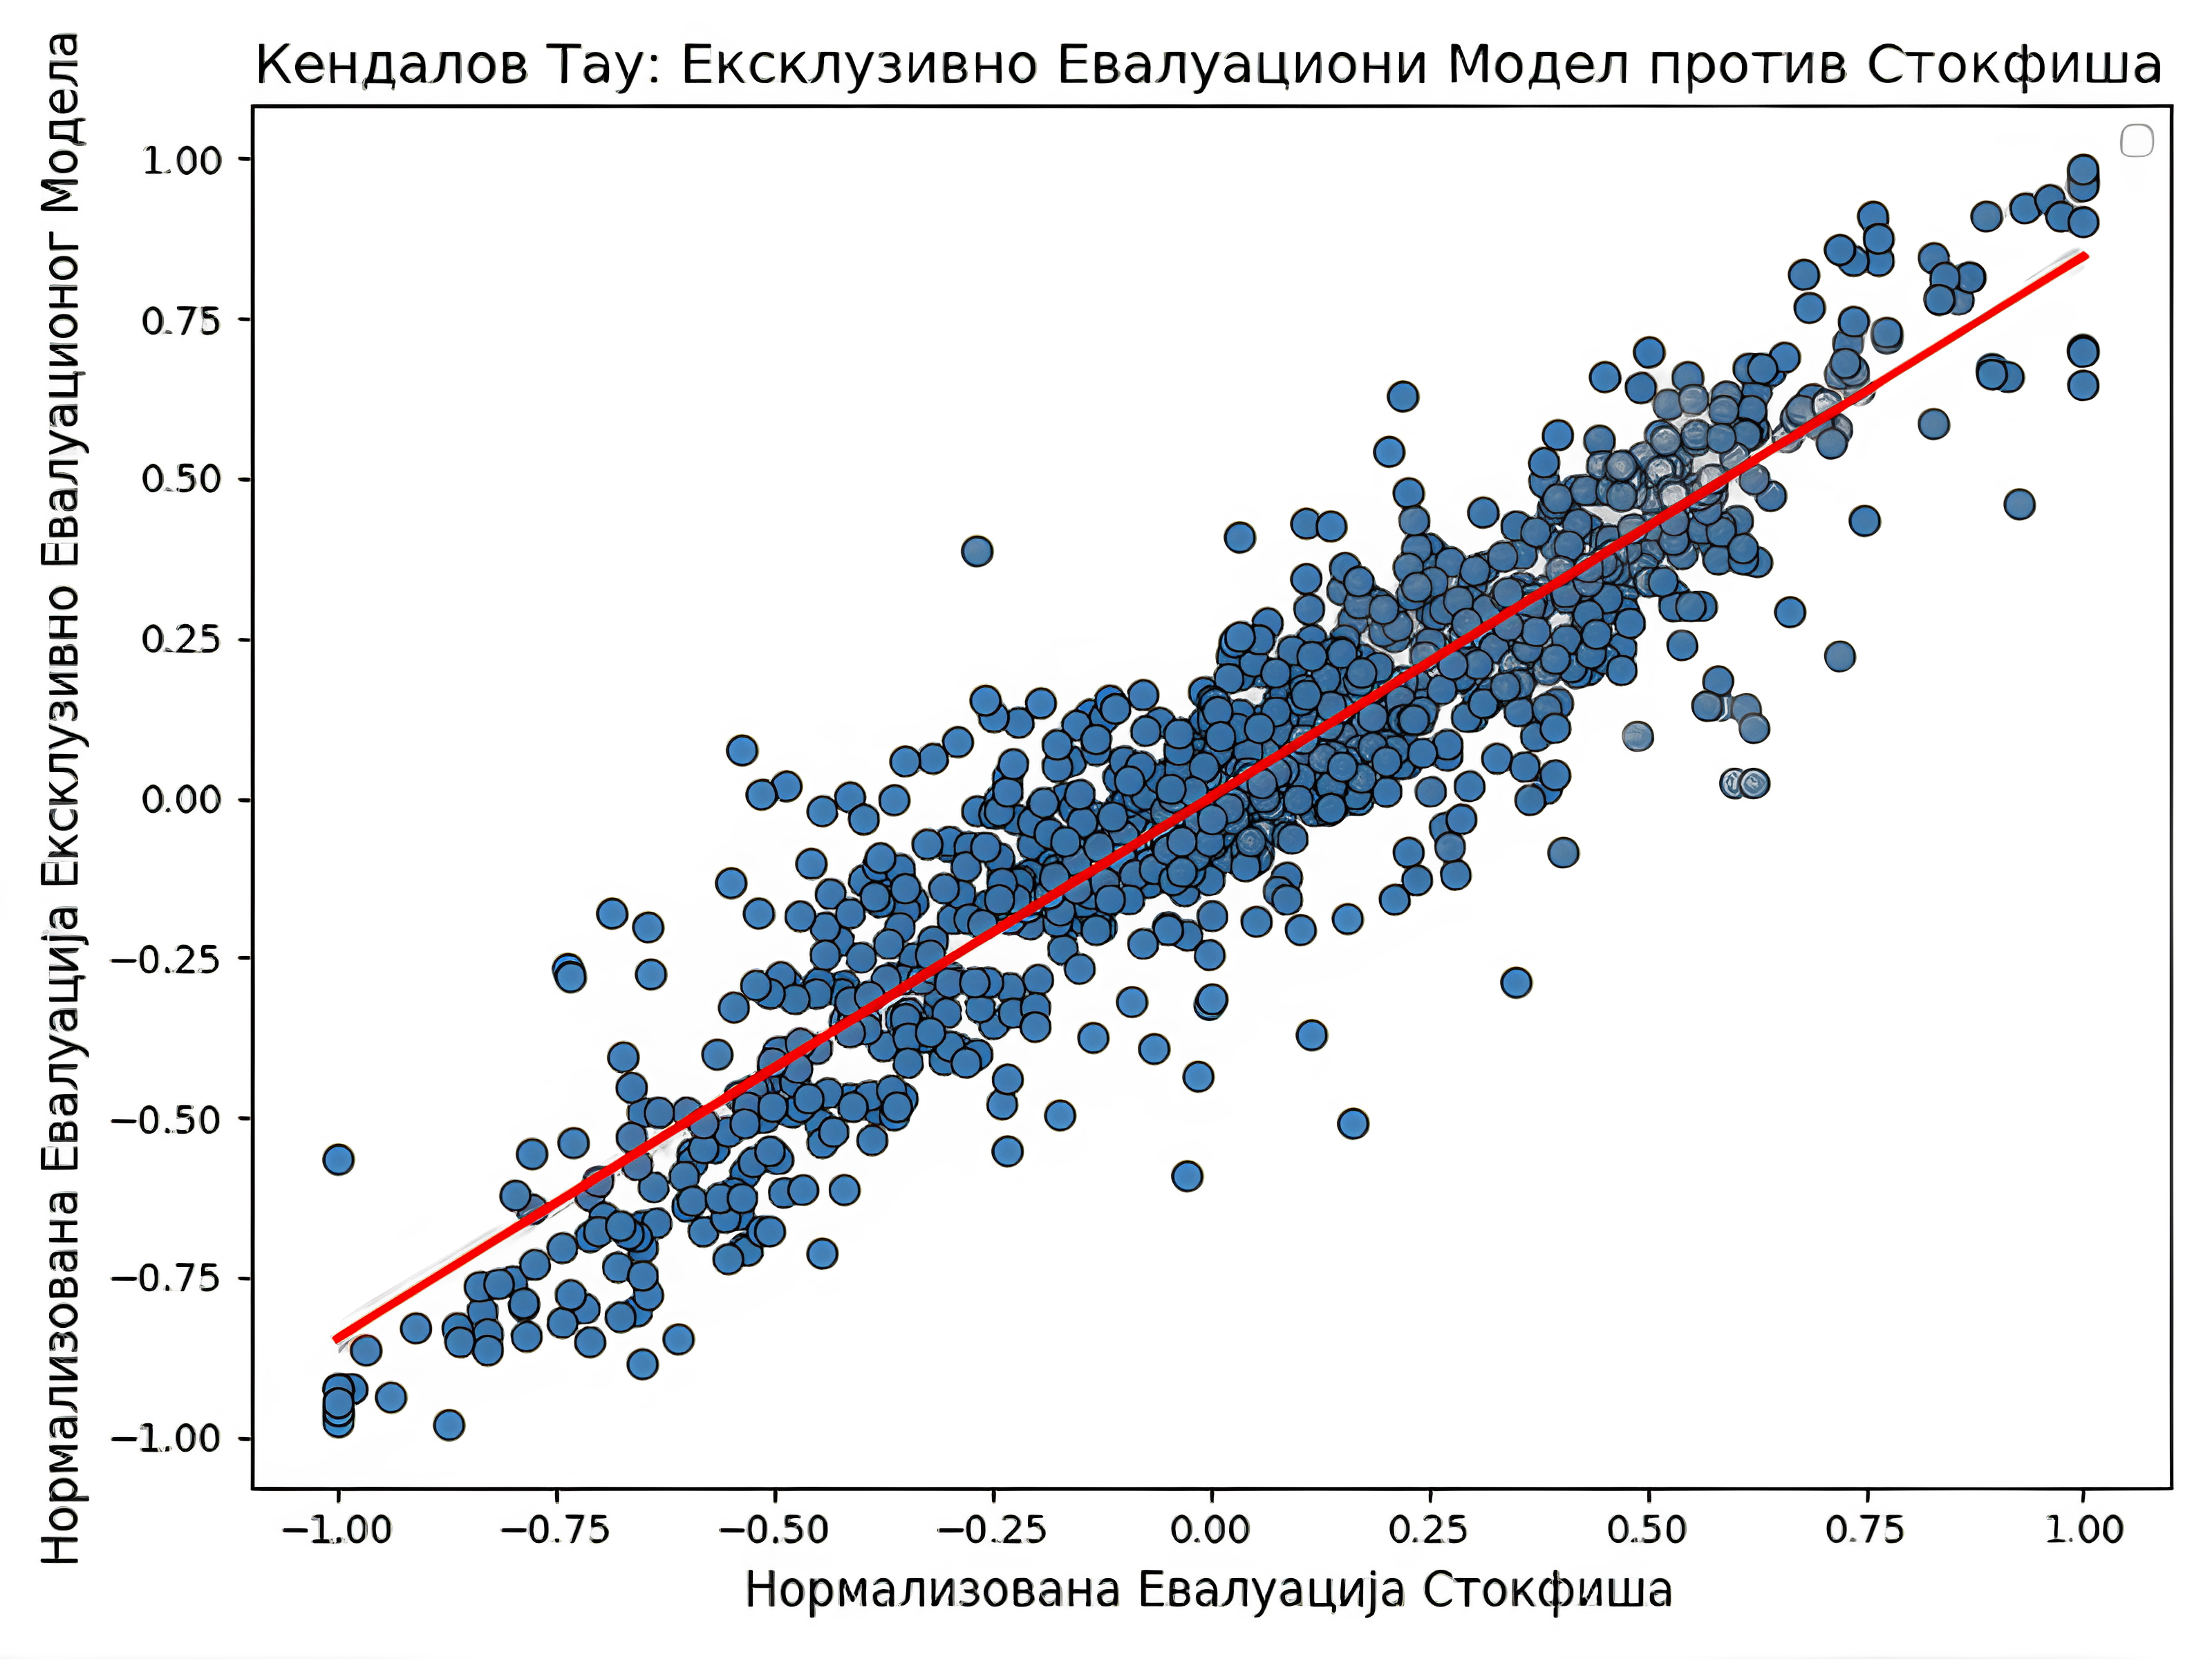
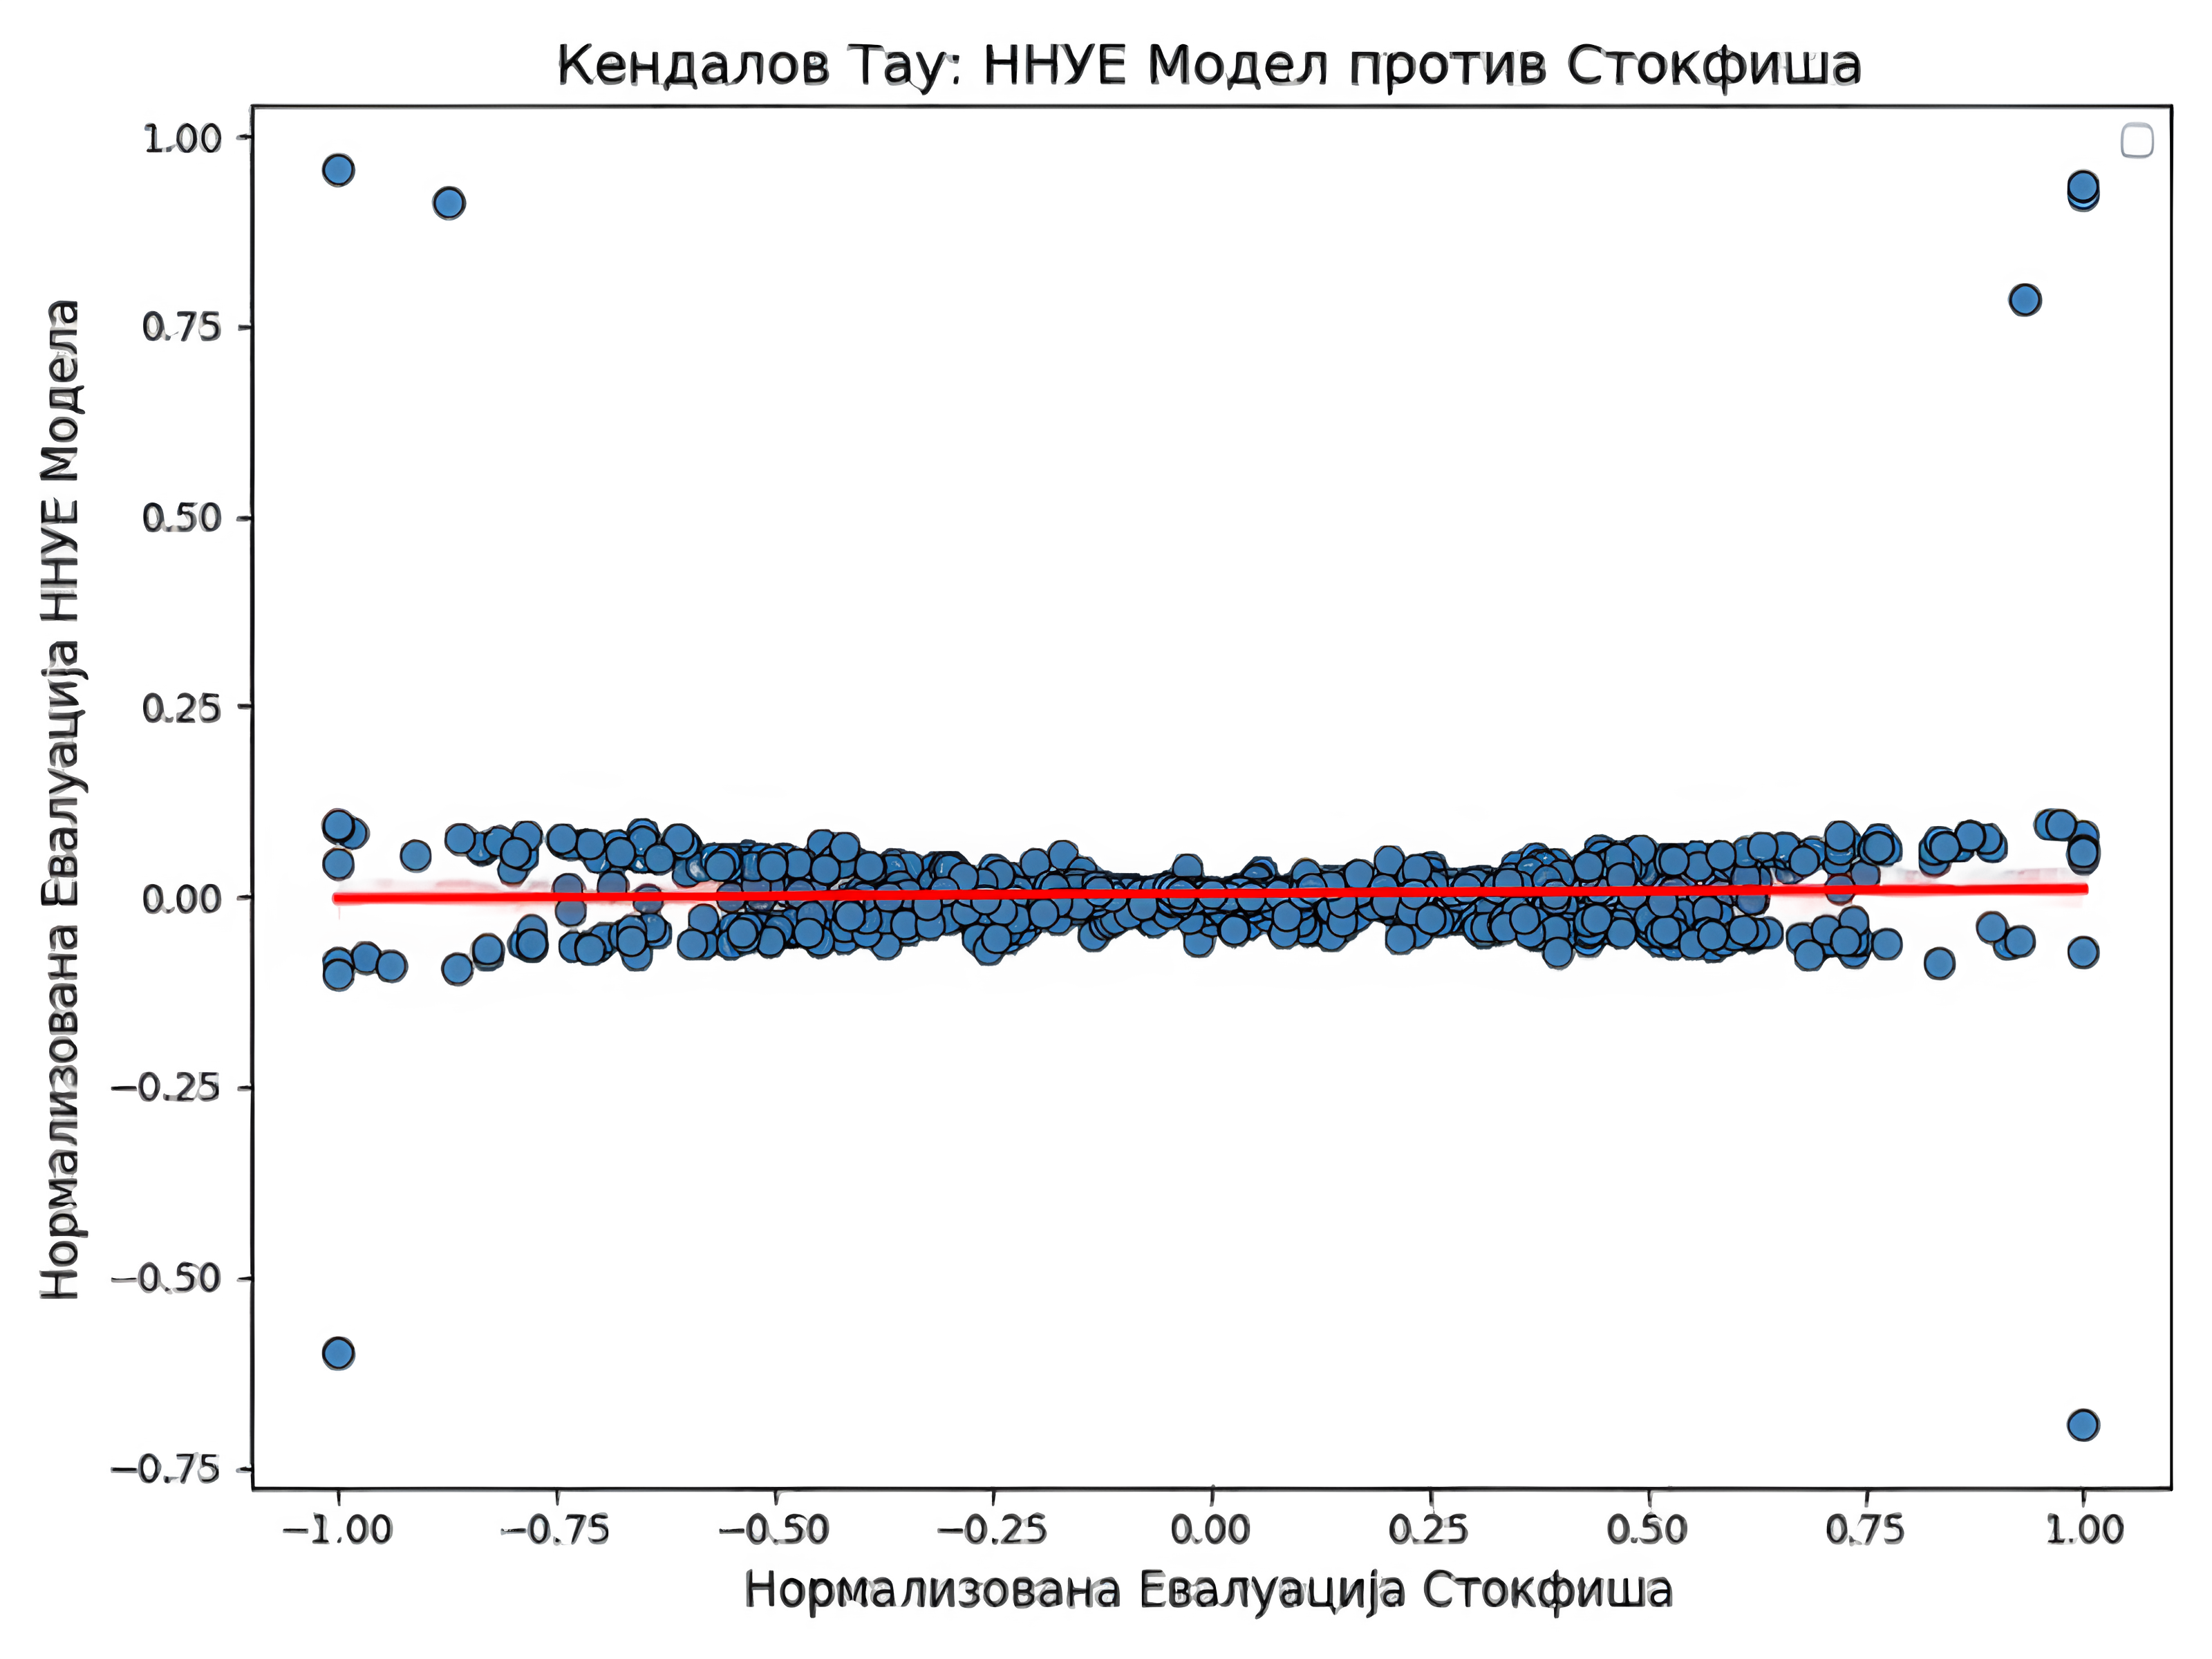
Glavna metrika koja meri uspešnost određenog modela ili igrača u šahu jeste njegov ELO11 rejting. Budući da određivanje ELO rejtinga zahteva igranje velikog broja partija sa modelom čiji se ELO rejting već poznaje, a to iziskuje veliku količinu vremena odlučeno je da se uspešnost modela meri statističkom metodom Kendalov tau.
4.1. Kendalov tau
Kendalov tau12 ili Kendalov koeficijent korelacije rangiranja jeste statistička mera koja određuje korelaciju dve opservacije jedne pojave. U slučaju ovog rada Kendalov tau meri odnos evaluacije zadate pozicije navedenih modela i modela Stockfish na dubini pretrage 10 čiji se rezultat smatra istinskom vrednošću. Ekstremne vrednosti Kendalovog tau su -1 i 1, gde vrednost od -1 označava negativnu korelaciju (konkretno, jedan model bi odredio evaluaciju kao +h, a drugi kao -h), vrednost 0 označava odsustvo bilo kakve korelacije dok vrednost 1 označava pozitivnu korelaciju.
4.2. Grafici
Sledeći grafici prikazuju korelacije između evaluacije pozicije svakog od modela, sem MCTS metode, i evaluacije koju je izračunao najbolji šahovski računar Stockfish na dubini pretrage 10. Budući da je odgovor ResNet modela potez, a ne evaluacija zadate pozicije, ona se merila modelom Stockfish iz novonastale pozicije radi računanja korelacije.
| Model | ResNet model | Model „Dve glave” | Model eks. evaluacije | NNUE |
|---|---|---|---|---|
| Kendalov tau | $0.508138735333366$ | $0.4762867857297649$ | $0.7435471096073809$ | $0.027304966680253697$ |
4.3. Diskusija
Prva dva modela u tabeli imaju poprilično slične rezultate, što se može objasniti relativnom sličnošću u samoj arhitekturi. Primećuje se znatan skok u performansama modela ekskluzivne evaluacije. To može da ima par uzroka. Prvi je jednostavan. Fokusiranje mreže samo na evaluaciju pozicije joj omogućuje da se bolje optimizuje za tu svrhu. Drugi razlozi se tiču same arhitekture, poput veće dubine i povećavanje broja filtera na kraju u odnosu na početak mreže. Nažalost, takođe se primećuje kompletan neuspeh kod mreže zasnovanoj na NNUE arhitekturi. To sugeriše na to da je za taj broj parametara jednostavno neophodno mnogo više visokokvalitetnih podataka. Taj pogled potvrđuje činjenica da je Stockfish dodatno treniran na generisanim partijama drugog po redu šahovskog računara LeelaChessZero, koji je zasnovan na arhitekturi računara AlphaZero. Takođe, moguće je da je došlo do greške prilikom deljenja parametara između dve polovine mreže.
5. Zaključak
Projekat se bavio razvojem i implementacijom 5 različitih modela koji su imali za cilj da nauče da igraju šah po ugledu na najboljeg šahovskog računara sadašnjice. Model eksluzivne evaluacije, čija trenirana evaluaciona funkcija koja određuje koji je igrač u prednosti, uparen sa minimax algoritmom zarad pronalaženja najboljeg poteza, je pokazao najbolje rezultate. To sugeriše je da moguće, sa relativno malo računarske moći, razviti obećavajući šahovski računar koji je sposoban da pobedi prosečnog igrača šaha.
6. Dalji rad
Uzimajući u obzir samo koliko različitih pozicija mogu da se jave u jednoj partiji šaha, očigledno je da je za bolji šahovski računar neophodno jako veliki broj visokokvalitetnih podataka, a za obradu svih podataka je potrebno puno kompjuterske moći.
U slučaju da nije moguće nabaviti još računarske snage, rezultati najboljeg modela u ovom radu ipak pokazuju da je možda dovoljno imati duboku mrežu i dobar minimax algoritam. Ispitivanje te hipoteze bi bio centralni fokus u daljem radu na ovom projektu.
Jedna od mogućnosti za optimizaciju minimax algoritma jeste korišćenje principa dinamičkog programiranja za pamćenje evaluacija pozicija kako bi se izbegla ponovna obrada jednih te istih pozicija. Ova optimizacija bi mogla da smanji vreme izvršavanja i do dvadeset puta i poveća dubinu pretrage čime bi se šahovska veština programa znatno povećala.
Takođe, otvaranje u šahu je jedno od najbitnijih faza svake partije, međutim postoji mogućnost da je u bazi podataka ono nedovoljno zastupljeno. Kreiranje obimne knjige otvaranja može znatno uticati na performanse računara u realnim partijama.
7. Reference
-
D. Silver, T. Hubert, J. Schrittwieser, I. Antonoglou, M. Lai, A. Guez, M. Lanctot, L. Sifre, D. Kumaran, T. Graepel, T. Lillicrap, K. Simonyan and D. Hassabis, Mastering Chess and Shogi by Self-Play with a General Reinforcement Learning Algorithm. December 2017 ↩︎ ↩︎ ↩︎ ↩︎
-
FIDE, Laws Of Chess. November 2008 ↩︎
-
D. Klein, Neural Networks for Chess The magic of deep and reinforcement learning revealed. June 2022 ↩︎ ↩︎
-
K. He, X. Zhang, S. Ren, J. Sun, Deep Residual Learning for Image Recognition. Dec 2015 ↩︎
-
M. Świechowski, K. Godlewski, B. Sawicki, J. Mańdziuk, Monte Carlo Tree Search: A Review of Recent Modifications and Applications. March 2021 ↩︎
-
S. H. Fuller, J. G. Gaschnig, J. J. Gillogly. Analysis of the alpha-beta pruning algorithm. July 1973 ↩︎
-
A. Elo. The Proposed USCF Rating System, Its Development, Theory, and Applications. August 1967 ↩︎